1. 批量是怎么发生的
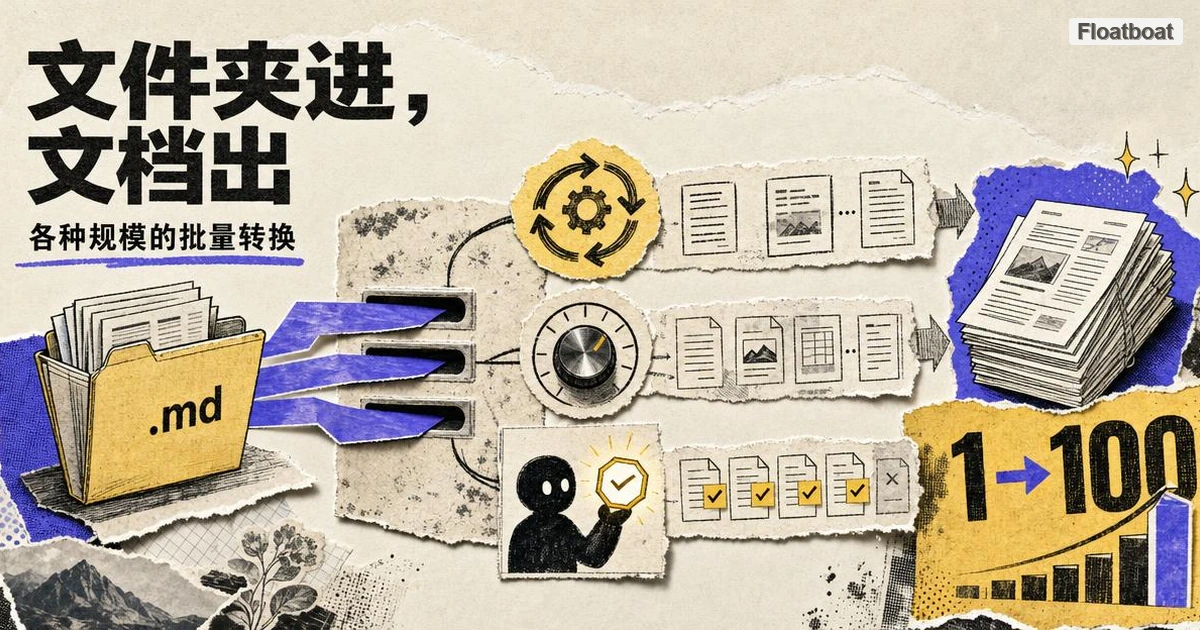
没有人一开始就打算转换几百个 Markdown 文件。它总是以事件的形式到来:团队离开 Notion,带走一个导出的 wiki 文件夹;研究者的笔记库要变成可分享的 PDF 存档;某个 AI 工作区一年来每天产一份 .md 报告,现在有人想要去年的全部合订。对日常单次转换完美胜任的单文件工具,在这个规模上撞墙——五十个文件过一遍浏览器转换器,就是五十轮拖拽、导出、重命名。
到这时问题的形状变了。不再是「这个文件怎么转」,而是「这个文件夹怎么转——可复现地,并且不用把同一个点击做五十遍」。
2. 路线一:脚本循环(免费、精确、偏技术)
经典答案是 Pandoc 加循环。任何有 shell 的系统上:
for f in *.md; do pandoc "$f" -o "${f%.md}.pdf"; done
十个文件或一万个,命令一样,而且可复现——这个循环本身就是「做了什么」的文档。Python 提供同样的形状加更多控制(遍历子文件夹、重命名规则、并行处理),Pandoc 手册按格式列出了转换选项。
诚实的局限:每个文件得到完全相同的处理,所以任何「按文件区别」的动作——从首个标题取 PDF 名、把文件名里的日期前缀清掉——都会让脚本从一行长成一个小程序。搭建成本也是真实的:安装 Pandoc 和它的 PDF 引用引擎的摩擦,在单文件转换指南里已经写过,乘以整个文件夹的赌注只会放大。先在副本上试。
3. 路线二:GUI 批量转换器
在终端和单文件工具之间,存在一类桌面批量转换器:选文件夹、选格式、运行。它们移除了脚本门槛,把常见情况——嵌套子文件夹、文件名模式——做进了界面。代价是控制力不如脚本、各工具的输出质量参差;对文件同质的一次性迁移,它们是合理的中间路线。重点检查表格和代码块的转换结果——弱转换器悄悄弄坏内容的地方就在这里。
4. 路线三:AI 驱动的桌面处理
最新的路线不再把文件夹当作 N 个相同的文件,而是 N 份各值得按内容区别对待的文档。有文件夹权限的桌面 agent 可以一边转换一边做脚本做不到的事:按每个 PDF 实际的首个标题命名、归档前先摘要一份对话记录、按内容重组文件、或者跳过并标记那些不该发出的草稿。这是「本地、私密」模式——文件留在磁盘上,agent 穿行其间——也是免费 Markdown 工具背后的产品阶梯的终点:单文件在浏览器免费,文件夹在桌面端。
代价是成本与信任。脚本循环免费且确定;agent 既不免费也不确定,对同质转换这笔交易毫无意义。它恰好在批量涉及判断时成立——混杂着笔记、日志和草稿的文件夹,没有任何脚本能公平地一视同仁。
5. 一个问题完成选型
问:所有文件值得同样的操作吗?是——用脚本(路线一),或把文件夹丢给 GUI 转换器(路线二)。否——每个文件需要判断——那是路线三,桌面 agent 的场景。追问是频率:一次性迁移能容忍手工搭建,每周的流水线不能,而且无论如何,周级管线都该把脚本提交进版本管理。
有一条实践对所有路线通用:先转换复制的文件夹,抽查输出——表格、代码块、以及页面转换来的表格是转换质量最先露馅的地方——然后再对真件运行。
6. 什么时候文件夹规模需要 agent
边界值得画一次,画清楚。单个文件加快速编辑:浏览器工具,免费,即时。同质转换的文件夹:脚本,免费,确定。每个文件都需要被理解的文件夹——摘要、命名、分诊、重组——那是 agentic 工作,属于桌面环境:agent 在本地读文件、对整个集合采取行动。
这条递进——单文件在网页免费、文件夹上桌面、判断交给 AI——就是产品阶梯在批量尺度上的样子。文件一直是纯文本;规模改变的是转换所需的判断量。
7. 每条路线保住了什么:质量对照矩阵
路线选择通常被框成「成本对控制」,但更具决定性的轴是:转换之后,什么东西完好地活了下来。一个文件夹可以抵达终点时文件名完美而表格稀烂,也可以表格干净而元数据荡然无存。下面这张矩阵,把三条路线放在六个最容易决定「转换后的文件夹还能不能用」的维度上对照:表格保真、代码块、frontmatter、图片链接、子文件夹、成本。
| 你在乎什么 | Pandoc 脚本 | GUI 批量转换器 | AI 桌面端 |
|---|---|---|---|
| 表格保真 | 高——标准管道表转换干净;花式排版取决于目标格式 | 因工具而异;简单表格通常无恙,宽表可能被裁 | 能读懂表格结构并重建,但每一次重建都是改错一个单元格的机会 |
| 代码块 | 逐字保留;PDF 输出需要配色或换行设置 | 通常保留;分页可能把长行切断 | 保留,还能按需重排、重格式化 |
| Frontmatter(YAML) | 被解析为文档元数据——除非模板主动输出,否则不进可见正文 | 经常被当字面文本塞进正文,或被悄悄丢弃 | 被读懂;可以带进文件名、标题或清单 |
| 图片链接 | 相对每个文件解析——路径完好就没事 | 参差;部分工具会丢相对路径 | 能逐条对着磁盘验证并修复断链 |
| 子文件夹 | 一句 find 的事 | 通常内建 | 内建 |
| 成本 | 免费 | 免费到便宜,看工具 | 订阅或按量计费 |
这张表值得读出两句话。脚本最强的位置恰好是赌注最大的位置——代码保真与确定性的图片解析——所以尽管有搭建成本,同质文件夹的默认答案仍是它。frontmatter 那一行是安静的陷阱:Pandoc 把 YAML 当作输入元数据而非正文,一个「运行成功」的脚本仍可能把所有标题和标签从可见输出里剥掉;GUI 工具则不可预测到只能做最坏假设——元数据不会存活。没有任何一行是三列中的全能赢家,这才是「用你最输不起的那一行来选路线,而不是用价格」的真正理由。
8. Frontmatter、文件名与清单(manifest)
批量转换最安静的死法不是表格坏掉——而是元数据丢失。一个文件夹,每个文件开头都带 YAML front matter 块(--- 围栏里的 title、date、tags——Markdown 速查表里的标准语法),转换之后可能出现三种下场:块没了;块被当字面文本塞进了正文;块还在,但接收文件的新系统读不出它。这种丢失扫一眼首页看不出来,所以往往几周后才暴露——某天有人搜一个已经不存在的标签。
修法是提前做决定:在运行之前,就定好 front matter 的三种命运里它该选哪一种。可以驱动输出:Pandoc 模板把 title: 拉进 PDF 元数据和 HTML <title>,脚本可以按 date: 或 tags: 分文件夹。可以可见地存活:HTML 的文档头装得下它,PDF 没地方放。也可以旁路保全:一个预检步骤把每个文件的 YAML 块抓进一份与输出同放的 CSV。三种都对;错的是不做选择——而默认发生的就是不做选择。
配套的实践是清单(manifest)——批量转换器的保险单。动任何东西之前先记录库存:find . -name "*.md" -printf "%p\t%s\n" > manifest.txt 存下每个路径和字节数,转换时加一列,把每个源文件映射到改名后的输出。中断的运行靠它变成可续跑的运行,改名操作靠它变成可回退的操作。Markdown 是纯文本,一千个文件的库存清单不过几千字节。文件名值得同样的纪律:空格、中文字符、日期前缀原则上都能活着穿过转换,但迁移中途手工改名三百个文件,正是文件夹走失的地方——要改名,就按清单里记录的映射改,绝不在唯一副本上原地改。
9. 失败模式画廊
每一次批量转换都会产生失败,而其中大多数来自同样三种模式。它们都不奇特;每一种都有可辨认的签名和一套纯机械的修复。在第一次真实运行之前把它们读一遍,比在第 300 个文件中的第 214 个现场发现便宜得多。
跑了一半停下的那一次
症状是:输出文件夹里躺着 214 个文件,而清单上写着 300——其中一些是零字节或截断的,因为进程在写一半时死了:一次 Ctrl-C、一次重启、一次引擎崩溃。预防是结构性的:输出写进独立文件夹,每个文件先写临时名再移动(原子写),每成功一个就记一条日志。修复:删掉零字节的输出,带跳过已有守卫重跑([ -f out.pdf ] || pandoc ...)——失败的那一次从此是检查点,不是重启。
以乱码形态到场的编码
症状是内容打开即特定风味的乱码:客户部署项目显示成 瀹㈡埛閮ㄧ讲椤圭洿——UTF-8 字节被套上 GBK 的镜片阅读,或者反过来。原因是 Pandoc 默认输入为 UTF-8,而来自旧版中文 Windows 工具、老编辑器和部分聊天软件的文件还是 GBK 或 GB18030。预防是一个预检:先探测每个文件的编码,统一规范成 UTF-8,让转换器永远不必猜。原始 GBK 文件完好,就从它们重跑规范化;被误读后又回存过的字节已经坏到无法修复,只剩备份一条路——这是「永远转换副本」的又一条论据。
留在原地的图片
症状是:文字转得漂漂亮亮,每张图却都是空框,或者 PDF 构建时喷出一串「could not fetch resource」警告——签名是 ../assets/diagram.png 这样的相对引用,因为文件在离开它的素材文件夹之后才被转换,引用从此无处可指。预防是位置性的:在原地转换,或者把 Pandoc 的 --resource-path 指向原目录树,并让素材文件夹与输出相邻。修复:拿清单核对断掉的引用,恢复文件所期待的相邻关系,重跑——路径从来没有错,它们只是成了孤儿。
10. 验证流程
进度条清空不等于运行结束;输出对过输入,才算结束。四项检查在几百个文件的规模上只花几分钟,却能抓住上面画廊里几乎全部的失败。「转换副本」和「验证副本」应该是一个动作,不是两个。
- 数目对齐。 源
.md文件数(含子文件夹)等于输出数——直接对清单。 - 首尾行读一遍。 抽样的文件以预期标题开头、在源文件结束的地方结束——暴露文件数看不见的截断。
- 图片引用可解析。 数一遍
![的出现次数、确认每个目标在磁盘上存在——一个脚本的事,瞬间抓住孤儿素材。 - 随机五篇读全文。 随机抽五个输出,与源文件并排真正读一遍。
最后一项是人们跳过的那项,也是唯一能抓住语义损伤的那项:章节被重排、表格变成段落、代码块吞掉了它后面的段落。数目校验的是信封;只有阅读校验的是内容。周期性流水线把四项全部脚本化,每批必跑;一次性迁移就手工做——那十五分钟阅读是整个工作流里最便宜的保险。
11. 来源核对:Notion 与 Obsidian 的导出
现实中的批量大多是迁移型批量,而最常见的两个来源是 Notion 和 Obsidian。两者都交给你一个 Markdown 文件夹,但各自的文件夹带着各自的习惯。
按 Notion 的导出文档(截至 2026 年 9 月),Markdown & CSV 导出每个页面产出一个 .md 文件;整页数据库导出为一个 CSV 加每个子页面一个独立的 Markdown 文件;callout 块因为 Markdown 没有对应物而变成裸 HTML。三个后果随之而来。评论只在 HTML 导出里存活——需要讨论串的存档,得为它们额外要一份 HTML。每个文件名都带 32 位页面 ID 后缀——把按清单驱动的改名步骤排进计划,别当成收尾清洁。Windows 上,「为子页面创建文件夹」开着时路径可能超过 260 字符上限,Explorer 解压会失败——关掉该选项,或用 7-Zip 解压。页面内容本身迁移良好——结构上接近 Markdown 笔记——前提是上面几个边角先处理掉。
Obsidian 库根本不需要导出步骤,因为库本身就是一个纯 .md 文件夹——复制文件夹就是导出。需要留神的是链接语法:[[wikilink]] 是 Obsidian 的约定而非标准 Markdown,Obsidian 之外的转换器会把它们当字面文本放过,留下一个每条交叉引用都断掉的库。往后的链接,修法是一个设置——在 Files and links 里关掉「Use [[Wikilinks]]」并选相对路径格式(依 Obsidian 文档,截至 2026 年 9 月);已经写下的链接,用社区插件在库里批量转换成标准 Markdown,再让文件夹去见任何转换器。附件也值得看一眼:相对路径引用的子文件夹,是图片能跟着笔记一起走出库的原因——也是日后能走进作用于同一文件夹的 AI agent 工作流的原因。
12. 三个文件夹,三条路线:30、300、3000
抽象的权衡在具体规模上会迅速落地,所以值得把三个覆盖了大多数真实情况的复合文件夹走一遍。路线随数量而变,「做完」的定义也随之而变。搞错的代价同样在变。
30 个文件——一次性的文件夹
一位顾问继承了三十份会议纪要,要给不用 Markdown 的客户转成 PDF,就一次。GUI 批量转换器对准文件夹,或者一条只敲一遍的 Pandoc 循环,几分钟内都能收工——这个体量下,路线不如验证流程重要。要避免的错误是过度工程:带编码预检的参数化流水线,用在三十个一模一样的转换上是浪费。转副本、跑四项检查、交付、把清单和输出一起归档。
300 个文件——混杂的图书馆
三百个文件时,文件夹开始显出纹理:子文件夹、日期前缀文件名、一两个编码不对、会毒死朴素循环的文件。这是脚本路线收回搭建成本的起点,因为循环加清单加独立输出目录加编码预检,合起来才构成一个可以停下、检视、续跑的运行。GUI 工具仍能对付,但「按文件区别」正是点击不再扩展的地方——每个「除了这一个」都变成一次手工往返。脚本还是那个能活下去的资产:下个季度的导出只需要改,不需要重造。
3000 个文件——流水线
三千个时,这就不是任务而是小型系统:跳过已转换文件的幂等、并行 worker、对清单做校验和验证、脚本本体进版本管理。把三千份文档上传给云端转换器,也与上传一份是不同的决定——文件去了哪里的隐私之问在这个规模会变成一场利益相关者对话,本地处理在这里占优,这也是原因之一。如果每个文件需要同样的处理,答案仍是脚本——一个更大、仪表更全的脚本。如果需要判断——分诊、摘要、逐篇重组——这就是 AI 流水线吃 Markdown 文件夹收回成本的地界,桌面 agent 路线从这里开始不再是奢侈品。
13. 结语
批量转换不是一个问题,而是一个家族:同质转换属于脚本,一次性迁移属于 GUI 转换器,判断密集的文件夹属于本地 agent。三者都从同一个地方出发——一个可移植的 .md 文件夹,其内容比处理它们的任何工具都活得久。
选路线之前,从文件夹里打开三个文件,问它们有什么共同点。答案会替你选好工具。
https://floatboat.ai/zh/blog/batch-convert-markdown-files