
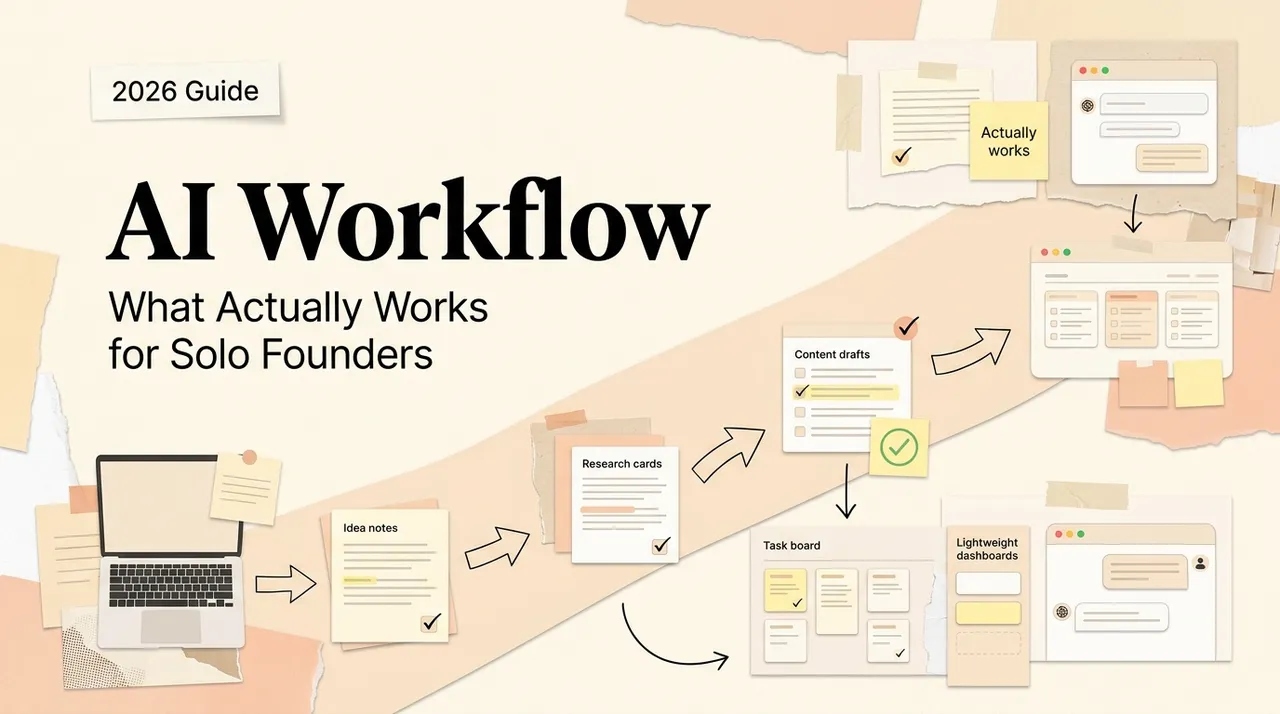
适合单人创业者的 AI 工作流,不是工具最多的技术栈,而是一套让重复工作稳定运行的小型操作系统:输入清楚、顺序明确、上下文获准、复核具体,而且每次运行都有记录。
设计单人业务的 AI 工作流时,先明确所需的组件、各层职责及连接方式。已经选好目标、准备搭建时,可按单人业务 AI 工作流落地步骤完成原型、测试与上线。
这篇文章回答「业务操作系统里应该有哪些层」:边界、状态、复核、记录与恢复。它不会重复配套文章中的审计、试点与上线步骤。标准与产品资料已于 2026 年 10 月 13 日复核。
从工作开始,不从软件开始
列出维持业务运转的重复结果:合格线索、客户 Brief、已发布内容、发票包、会议跟进或每周经营复盘。选一个结果,再从终点倒推路径。
适合自动化的工作通常重复、有边界、可观察,而且即使最后仍由人批准也有价值。成功标准主观、输入持续变化,或一次错误会形成不可逆承诺的任务,不适合作为起点。
把流程写成:
触发 → 输入 → 决策 → 动作 → 复核 → 事实源 → 完成
这会暴露任务是否真的需要 AI。固定规则留给确定性逻辑;模型只负责解释、抽取、分类、起草,或在受限选项中做判断。
一条耐用 AI 工作流的七层结构
1. 触发
日历事件、新表单、文件夹变化、定期复盘还是人工请求?同时定义重复事件和迟到事件怎么处理。没有负责人的触发器容易静默失败。
2. 输入与上下文
当前运行必需的输入,与可复用上下文要分开。可复用部分可以是风格指南、客户规则、产品事实、模板或决策政策。
每个信源都要有负责人和更新时间。上下文并非越多越好,过期或冲突资料会让错误答案更自信。缺失时应明确报告,不能补猜。
3. 决策逻辑
标明哪些决定是固定规则,哪些需要判断。每个 AI 判断都要定义允许输出、证据要求、不确定处理和升级路径。“自行决定怎么办”不是控制政策。
4. 工具与动作
选择最稳定的接口。受支持 App 或 API 通常比视觉点击稳定;依赖网页界面时才用浏览器控制;本地文件或应用可能需要桌面控制。
每个工具只给最低权限,读取与写入分开。发送、发布、删除、购买、改权限和编辑业务主记录,在通过代表性评估集之前必须审批。
5. 复核与异常
定义复核者能看到什么:建议结果、信源、变更、不确定点和下一动作。也要定义何时停止:缺数据、指令冲突、系统不可访问、数量异常或动作越权。
目标不是消灭人工,而是把判断集中到重要位置,移除机械交接。
NIST 生成式 AI 风险管理框架同样强调按场景设计:不同用途需要不同的人机分工、审阅、记录和管理监督。
6. 事实源
明确权威结果放在哪里。聊天记录通常不该成为唯一事实源:客户状态进 CRM,发票进财务系统,决策进决策日志。
保存能把一次运行与来源记录、外部动作连接起来的 ID,才能避免重复并支持恢复。
7. 可观测与恢复
至少记录运行 ID、输入与信源版本、配置、工具调用、审批、错误、终态、成本与外部动作 ID,但不要记录密钥或无必要个人信息。
围绕副作用设计重试。重复写入前先确认第一次是否成功;无法安全处理的案例进入人工队列。
三种架构模式
**带 Playbook 的助手:**用户启动、提供输入并复核,适合变化较大的知识工作,也是最安全的起点。
**带 AI 步骤的确定性工作流:**代码或自动化平台控制路径,AI 只做窄范围解释或生成。触发、分支、重试和记录都更明确。
**使用受限工具的 Agent:**模型根据发现选择下一步。只有路径确实需要动态改变时才使用,并配套更强权限、评估、轨迹、停止条件和恢复。
不要因为 Agent 听起来先进就选择它。只有模型决定执行顺序能产生足够价值时,才值得承担额外成本和波动。
什么适合放进同一工作区
统一工作区可以减少重复拼上下文,但集中不等于架构正确:业务权威记录留在源系统;凭证留在受管连接或密钥系统;可复用方法进入版本化指令或 Skill;临时上下文到期即清理;审批能追溯到人;指令、数据、测试和运行证据可以导出。
工作流应连接系统,而不是让一段聊天历史成为业务唯一副本。
设计评分表
| 维度 | 问题 |
|---|---|
| 业务价值 | 哪个重复结果会改善,如何观察? |
| 稳定性 | 输入、规则、异常与负责人是否稳定? |
| 上下文 | 信源是否获准、最新、最小且可追溯? |
| 控制 | AI 判断是否受限,高影响动作是否复核? |
| 可靠性 | 能否发现故障、避免重复写入并恢复? |
| 经济性 | 包含人工复核后,每个验收结果成本多少? |
| 可迁移 | 指令、数据、测试与运行证据能否导出? |
回答不了这些问题的方案,无论 Demo 多好看都不该进入生产。
避免工具堆积
按层选择,而不是按品牌选择:事实源;触发与确定性编排;负责判断与创作的模型或工作区;负责获准读写的连接工具;评估、轨迹与告警。
一个产品可以覆盖多层,但所有权必须清楚。新增订阅前,问它承担哪个独特角色、复制了什么数据、失败会怎样、如何退出。
不要首先自动化什么
不要从价格承诺、法律申报、付款、删除、账号权限、员工决定或无人复核的客户承诺开始;也不要自动化一条无人负责、无人理解的流程。决定什么信息应该被记住、纠正、过期和删除之前,不要先造持久记忆。
从准备型工作开始:收集证据、整理输入、起草结果,然后停下来审批。这既能产生价值,也能暴露真正异常。
设计阶段的交付物
完整设计应留下:一页任务契约;触发、系统、决策、动作与审批图;上下文和数据清单;工具权限矩阵;成功、严重错误和升级标准;评估集;运行记录与恢复计划;负责人、复查日期和退役路径。
完成这些后,使用上文的配套落地指南,让设计接受真实案例检验。若要扩展产品视野,可比较适合业务自动化的 AI 工具;若要换一种分工方法,可参考一人公司的角色型 AI 工作流。
相关文章
Markdown 简历——维护一份源文件,按需导出每种格式
把简历收进一个 Markdown 源文件,按需导出打印级 PDF、Word 和网页,招聘季不再从头排版。本文讲清简历的 Markdown 文件结构与 YAML 头写法、git 版本管理、三条导出路径的取舍,以及 ATS 机器解析到底读得到什么、又不能承诺什么。
Markdown 笔记工作流——比任何应用都活得久的记笔记方式
一套基于纯文本 .md 文件的笔记工作流:文件命名、标题分层、双链与 AI 辅助整理。为什么纯文本笔记比任何应用绑定都长寿,以及一个下午就能搭好的最小配置与长期维护习惯。
Obsidian Vault 是什么?文件、设置与边界讲清楚
Obsidian Vault 是设备上的本地文件夹,里面包含 Markdown 笔记、附件和该 Vault 专属的设置。本文讲清它实际存了什么、本地存储不等于什么,以及何时该拆分多个 Vault。
https://floatboat.ai/zh/blog/ai-workflow-solo-founders