
嗨,我是 Nova。我独自运营内容业务已经有一阵子了。过去某一年里,我开始留意一件悄悄蚕食我一天时间的东西:花在向 AI 工具重新解释自己上的时间。
不是写提示词,不是改稿。只是……重新自我介绍。一遍又一遍。我的语气规范、我客户的命名约定、三轮会话前我们早就定下的文章结构决定。每一次,全部从头来。
我开始管它叫「重新解释税」。一旦我注意到它,就再也无法无视它无处不在的身影。
「无状态 AI」在工作里到底让你付出什么
重新解释税——光为了找回上下文,你就烧掉多少 token
真实体验是这样的:你开一个新对话,把简报贴进去,然后花接下来十分钟解释——你的写作风格、客户的品牌语气、上周你早就排除掉的方向、为什么你惯用的标题格式不适用于这一篇。
你刚花了 20 分钟,给两天前「本来知道」这些上下文的 AI 重新交代了一遍。其实它不知道——因为每轮会话都从零归零。
这不是 bug,是设计使然。无状态 AI 平台独立处理每个请求,对之前的交互没有任何记忆。每次用户和 AI 互动,系统都把这次会话当作一段全新的对话——不依赖过往交互的历史数据来生成回应。
这种架构选择有真实的取舍。无状态系统更容易扩展、行为更可预测。但代价每一轮都完全落在你——用户——身上。你并没有随着时间得到更聪明的 AI,你只是变得更擅长重新解释自己。
这里隐藏的生产力损耗,研究者称之为「prompt 工程开销」:每开一个新对话就要不断重新塞入上下文的认知负担。这种架构限制造成几个显著问题:开发者和用户必须不断把上下文塞进每条 prompt,导致 prompt 又长又复杂、难以维护;计算低效——系统反复处理相同或相似的上下文信息;而由于没有对用户偏好和过往交互的持久记忆,AI 系统很难提供真正个性化、随时间改进的体验。
正如一位研究者精辟的比喻:这种体验就像访问一个每次翻页都会把你登出的网站——逼着你反复重新认证。
为什么这个问题对一人公司比对团队更疼
这是我看到很少有人充分讨论的部分:这个问题与团队规模成反比。
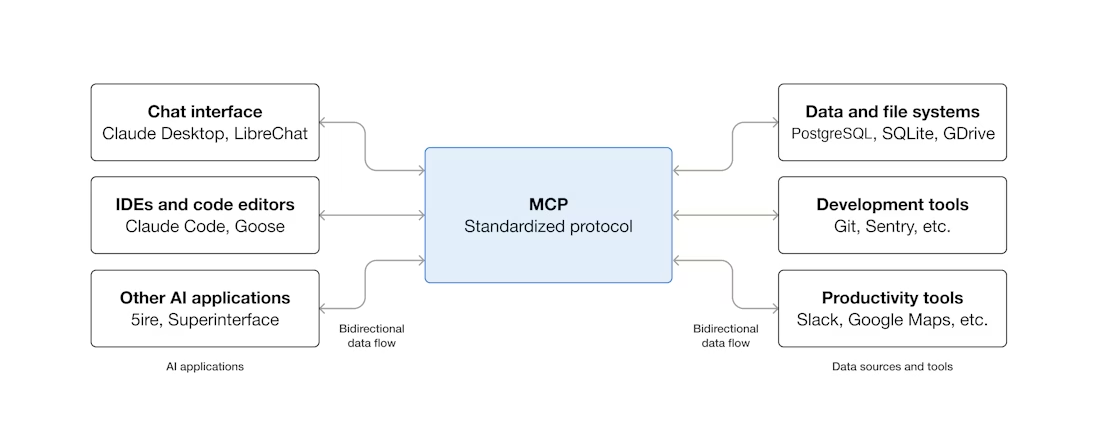
在较大的团队里,上下文散落在多个地方——共享文档、项目管理工具、Slack 历史、入职材料。AI 不需要记住一切,因为组织基础设施替它记住了,早有人把东西写下来了。
当你是单枪匹马在运营呢?你_就是_那个组织记忆。而当你的 AI 忘了你,没有任何后备系统来填补空缺。你得自己当那个后备系统。每一次都是。
我有很多个早晨,在真正开工之前,都用来重建本应是持久上下文的东西——重新贴风格指南、重新解释客户预期、重述几周前就做好的决定。那不是提示词问题,是结构问题。
AI 会忘掉的三类东西——哪些最要命
不是所有被遗忘的上下文代价都一样。我发现分成三类想很有用。
你的工作风格与标准
这是地基层——也是重建成本最高的。你偏好的句子长度、怎么处理技术性解释、你明确让它避开的措辞、对某个特定客户该多正式或多随意。这些偏好不会随会话改变,但如果没有持久的工作用 AI 记忆,你每一轮都得重述一遍。
痛苦的讽刺是:你的风格越具体、越精炼,归零的代价就越贵。一个没有风格的写手,AI 忘了也无所谓;一个精心打磨出自己声音的人,损失就大了。
已经决定过的事
这一种最让人措手不及。你已经决定这篇文章不放竞品对比;你已经为这个客户排除了「10 个技巧」格式;你已经敲定了一个特定的叙事框架。
开个新会话,这些全都不存在。AI 会兴高采烈地再次建议加竞品对比。你会再次拒绝。你会再次解释为什么。对进行中的项目来说,无状态设计是个严重问题。单个项目还撑得住——你可以在每轮会话开头贴一段摘要。但多个项目会让这套做法彻底失效。
等等,它连这种事也干?重新提出你已经关闭的决定?是的。每一次。
你的文件与工具怎么关联
第三类更实际:你的 AI 不知道哪些文件存在、你的文件夹怎么组织、哪一版文档才是当前版、哪个工具负责你工作流的哪一段——除非你告诉它。又一次。
「AI 助理」与「真正融进你工作的 AI」之间的差距,在这里暴露得最明显。一个不了解你工作区的工具,只能帮你做孤立的任务;它没法帮你把项目往前推。
为什么聊天式 AI 从设计上就没打算记住你
会话 vs 工作区——一个根本性的设计差异
人们日常使用的大多数 AI 工具都建立在会话模型上。会话有开始有结束,发生在它里面的一切都对 AI 可见,它外面的一切都消失。
当 AI 主要是搜索或问答工具时,这完全讲得通——无状态、快速、可扩展。让客服聊天机器人易于扩展的同一套架构逻辑,放到横跨数天、数周甚至数月的知识工作上,就真的成问题了。
开发者经常试图在无状态工作流里「假装有记忆」:在客户端累积对话历史,每次请求把完整消息历史一起发上去。这种「prompt 填充」做法的缺点很明显:token 成本随对话长度线性增长、上下文窗口限制导致旧消息被截断、prompt 变大延迟变高。短对话没问题,互动一累积就崩。
大多数人最终采用的变通办法——每轮会话开头贴一份上下文文档——恰恰就是 prompt 填充。它能用,但繁琐、不一致,而且撑不过两三个进行中的项目,就会变成一份新工作。
工作区模型则不同。它不是每轮从零开始,而是在会话开始时加载一份持久状态——你的偏好、你的决定、你的项目历史——从你上次停下的地方接续。正如 Anthropic 关于构建高效 Agent 的研究所指出的,最可靠的 Agent 系统之所以在上下文管理上大力投入,正是因为「AI 进场时知道什么,决定了它出场时产出什么。」
这个区别很重要:会话是对话,工作区是基础设施。
「能记住你的 AI」到底长什么样
记忆、上下文与可复用执行的区别
这三个词常被混用,但它们不是一回事——混用它们就会带来失望。
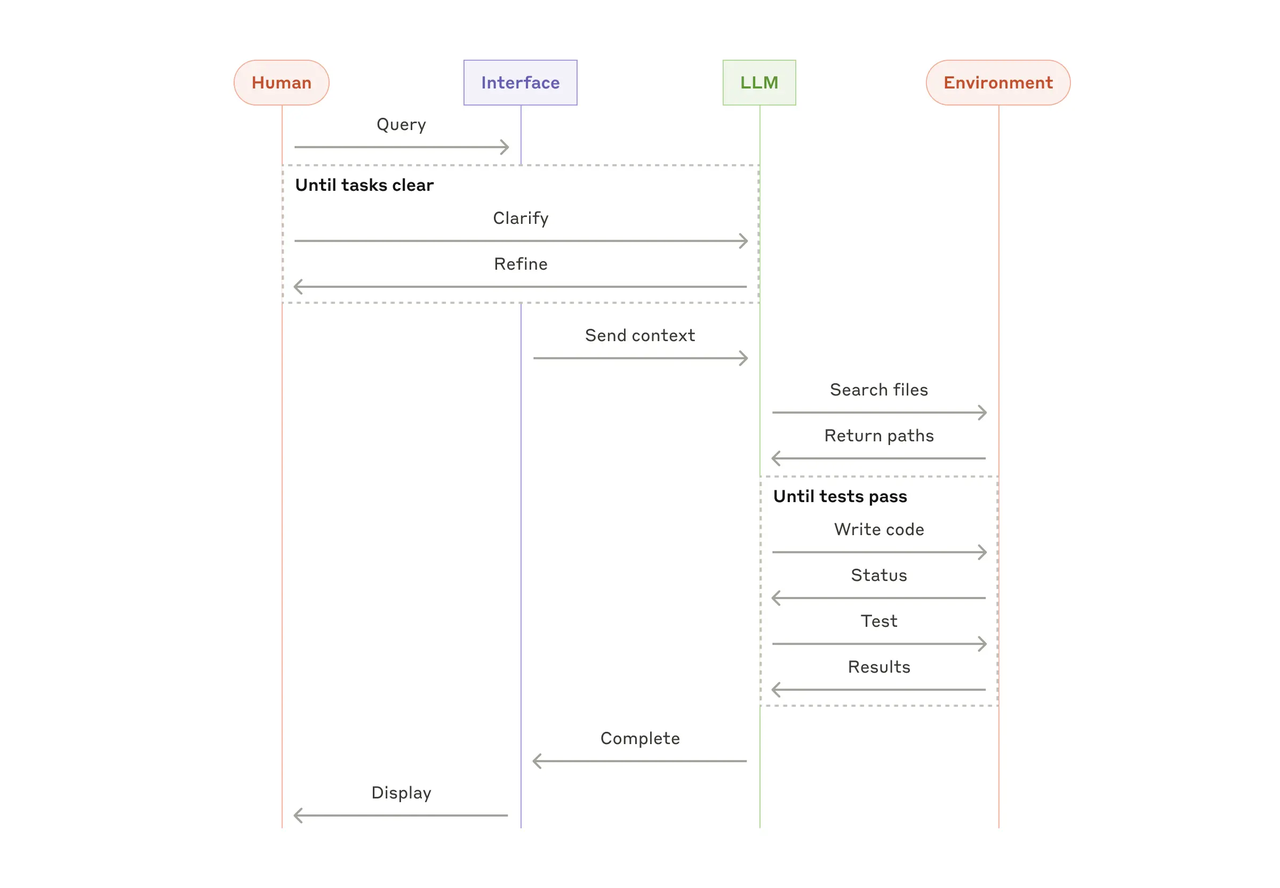
记忆是存储「你偏好要点式摘要而不是长段落」这个事实。上下文是把那个偏好加载进会话、让 AI 真的用起来。可复用执行是搭一条每次都用你的偏好、你的文件、你的标准去跑同一任务的工作流,不需要你重新构建。
眼下多数「AI 记忆」功能只是狭义上的记忆:它们存了一些关于你的事实,却未必把这些事实转化为一致的执行。
The New Stack 对 AI Agent 记忆架构的深度分析描述了四种能真正让 AI 跨会话有用的记忆:工作记忆(此刻正在做什么)、情景记忆(过去会话发生了什么)、语义记忆(AI 学到的关于你的东西)、程序记忆(如何真正做好你的重复性任务)。多数现有工具只有第一种的碎片、第二种的痕迹,真正的缺口在第三、第四种。
2025 年是「只保留、不理解」的一年。厂商争先恐后地上记忆功能——从持久聊天线程、长上下文窗口,到 AI「记忆空间」和公司知识库集成。这些都是向前的好步子,却没有解决真问题:AI 系统能回想事实,却仍然缺乏理解。它们知道发生了什么,却不知道那为什么重要。
那才是真正让单人创业者花钱买时间的缺口。不在于 AI 能不能记住你的名字,而在于它能不能理解你_为什么_做那些决定,并把那种理解带向未来。
想要能带着上下文往前走的 AI,该看什么
这里我会务实一点而不是做评测——这个领域里我没把所有方案都测遍,品类又变化很快。但基于我一直在做的实验,以下是我会真正去找的东西。
**跨会话而非单会话内生效的持久偏好。**不是一份你手动贴的文档,而是系统自动加载的、真正被存储的偏好。
**决策日志。**某种能跨会话边界记录「我们定了 X,因为 Y」的机制。这是大多数记忆功能仍然处理不好的类别。
工作区级感知。 AI 应该知道哪些文件与项目相关,而不只是你贴进 prompt 的东西。Tribe AI 对上下文感知记忆系统的研究区分了「信息检索」(按需找事实)和「运营记忆」(知道一个进行中项目的状态)。单人创业者需要的是后者。
**默认携带上下文的可复用工作流。**目标不只是 AI 记得你,而是它能正确跑你的重复任务、而不需要你每次重建上下文。
顺带一提,一些企业平台已经在往这个方向走了。比如 Google 的 Vertex AI Agent Builder 最近宣布 Memory Bank 转为全面可用——允许 Agent 在多次交互间为生产负载维持上下文。有状态 AI 的基础设施正在平台层成熟;它能否以个人知识工作者够得着的方式落地,还是未解之问。
仅供参考:Sphere Inc 对 AI 上下文缺口的分析发现,多数组织真正需要的不是留存——而是理解。AI 不仅要存下说过的话,还要能推理它为什么重要。我觉得它说得对,而我们还处在早期。
我不确定自己已经彻底想清楚了自己的解法。我仍在实验——对不同类型的项目,有的组合比别人更顺手。但我确实知道一件事:重新解释税是真实的,而给它命名,是修好它的第一步。
以上基于我独自运营内容业务的亲身体验,以及我对 AI 记忆架构做的研究。这里提到的任何一方都没有付过我钱。如果你正在实验持久上下文方案,我真心想知道你发现了什么——这个领域跑得很快,我自己也还有一部分没弄明白。
上一篇:
常见问题
是不是每款 AI 工具都会在会话之间忘掉我?
这不是上下文窗口该干的活吗?
如果我不换工具,最快的变通办法是什么?
AI 记忆和 AI 上下文有什么区别?
这个问题会随着 AI 变强而自动解决吗?
这是单人工作才要想的问题,还是团队也会遇到?
https://floatboat.ai/zh/blog/why-ai-forgets-every-session