
OpenAI GPT-6:为什么一人公司现在就该准备
GPT-6 即将发布。但真正该准备的不是「GPT-6 策略」,而是工作底下的脚手架:可复用的工作流、能迁移到任何模型的上下文体系。本文整理已知信号与时间线,并给出在新模型落地前就该做好的准备清单。
你好,我是 Nova。几个月来我一直有一搭没一搭地关注 GPT-6 的传闻周期,主要因为运营一人业务的朋友们总问我同一个问题:我是不是该做点什么准备?
诚实的答案:大概是该,但不是你想的那样。真正要准备的不是"一套 GPT-6 策略",而是你工作底下那层无聊的脚手架——也就是决定"一个更好的模型是真让你变快了,还是只是给了你更多拖延的姿势"的那些东西。我以前在这方面错过,所以让我带你过一遍我拼出来的图景。
目前关于 GPT-6 我们知道的
已确认的信号 vs 猜测
让我先把这事捋清楚,因为现在的信噪比很差。
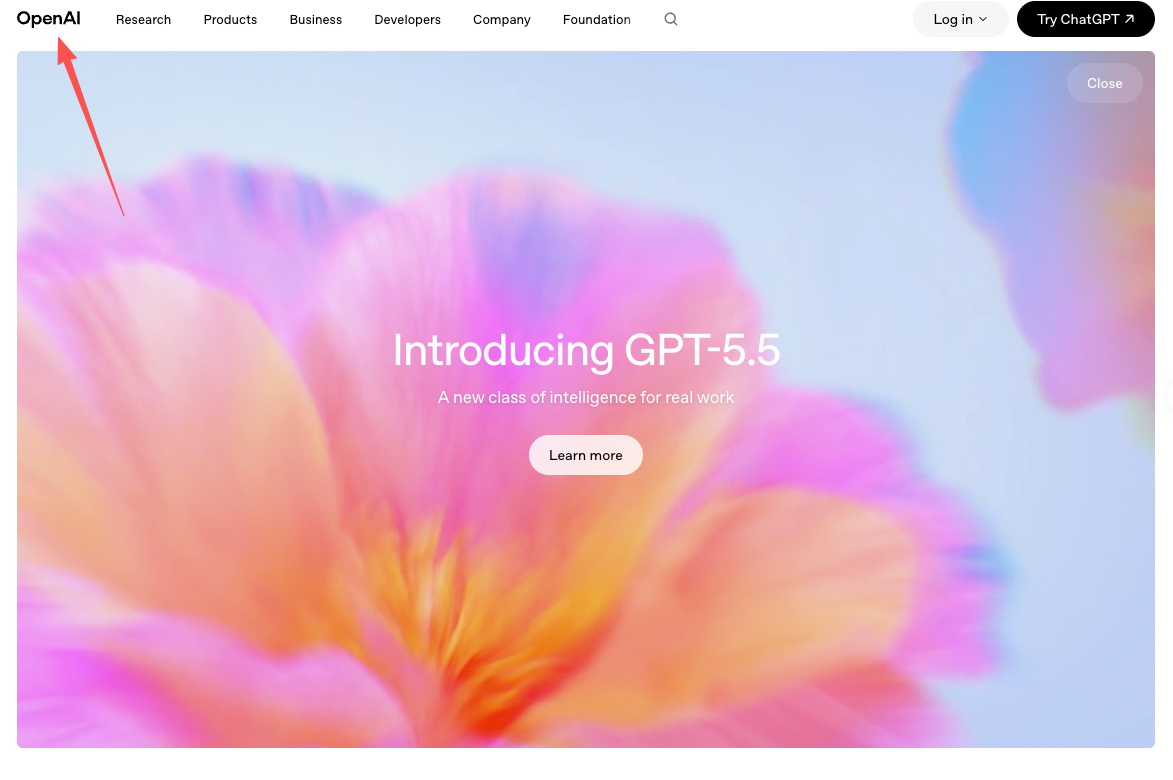
**已确认的。**OpenAI 下一代前沿模型的预训练——内部代号 "Spud"——已于 2026 年 3 月 24 日在得克萨斯州阿比林的 Stargate 数据中心完成。Sam Altman 公开说过,发布"还要几周"。就这些。没有模型卡。没有 API 公告。OpenAI 官网上也没有任何点名 GPT-6 的博客文章。写下这段时已是 4 月底,距离那句"几周"已经过去大约四个半星期,旗舰模型仍在安全评估阶段。
**纯属猜测的。**其他一切都是。200 万 token 上下文窗口的传闻。比 GPT-5.4 提升 40% 的说法。4 月 14 日的发布时间来了又走,悄无声息。Polymarket 上原本贴着"6 月 30 日前"、概率接近 93% 的交易者,一周内把它砍到了约 45%。这不是市场犯糊涂——这是市场在说"推迟几个月"现在完全有可能。
其实 Altman 公开说过的内容比那些泄露更有用。他讲到他最兴奋的功能是记忆——能跨周记住你的偏好、日常习惯、进行中项目的 ChatGPT。他谈到"agentic"工作流。他谈到个性化。那是一个方向,不是一份规格表。
现在任何给你 GPT-6 基准数据的文章,我都会当同人文看。
来自公开渠道的时间线估计
把能找到的信息拼起来,我的最佳猜测是:2026 年 Q2 末或 Q3。这与 Altman 的"还要几周"(宽泛解读)、4–6 周的标准安全评估周期,以及 Anthropic Opus 4.7 于 4 月 16 日发布和其他 Q2 发布带来的竞争压力,都对得上。
可能更早。可能更晚。我可能猜错。把 OpenAI 的发布说明存个书签,别再刷 Twitter 了。
GPT-4 到 GPT-5:每一次跃迁改变了什么
这里历史真的有用。
新能力 vs 实际的工作流变化
GPT-4 于 2023 年 3 月发布。GPT-5 于 2025 年 8 月 7 日发布。间隔 29 个月——而据 OpenAI 的官方发布页称,GPT-5 是一次"重大跃迁",拿到了 SOTA 分数:AIME 2025 上 94.6%,SWE-bench Verified 上 74.9%,MMMU 上 84.2%。相比开启搜索的 GPT-4o,幻觉下降约 45%。
读到这些,你会预期单人创业者感受到一种"29 个月的进步压缩进一天"式的剧变。
但事情并没有那样发生。
发布那一周我记得很清楚。Altman 后来自己承认那次发布"彻底搞砸了"——模型技术上更强,但手感比 GPT-4o 更冷、更不亲切,用户反弹大到 OpenAI 不得不把 4o 加回来作为选项。我那些天天用 ChatGPT 的朋友,大多数人花了一周对比输出、耸耸肩,然后带着小幅调整回到原来的 prompt。
对单人创业者来说,工作流变化是真实的,但很小。代码更好。事实性工作上的幻觉更少。持续推理链更长。没有谁的日常节奏被重连。
为什么更强的能力不自动等于更多的产出
这是我想认真停留的部分,因为我错了好长时间。
我曾经以为,更好的模型一发布,prompt 写得好的人会立刻跑得更快。这个逻辑看起来滴水不漏:同样的输入,更聪明的引擎,更好的输出。我漏掉的是:大多数单人创业者的瓶颈不是模型能力,而是模型_周围_那团乱糟糟的部分——想清楚你真正要什么、把对的上下文喂进去、复核它交回来的东西、决定发什么。
更好的模型让第 3 步变快。第 1、2、4、5 步该多慢还是多慢。
我试着还原自己从 GPT-4 到 GPT-5 的迁移,诚实地评估提速:在我已经有成熟工作流的任务上,大概 15%。在我没有工作流的任务上,零到负——因为我又开始调 prompt、跑对比、对着本来可能没问题的输出反复自我怀疑。
更强的能力,同一个瓶颈
每次重大模型发布都会重演的模式
看过几个周期之后,这个形状是可以预测的:
第一周:所有人拿自己最爱的小任务给新模型做基准测试,把结果发上推。第二周:那些围绕旧怪癖搭工作流的人,发现还没绕过去的新怪癖。第三周:有良好系统的人安静地获得一次提速;没有系统的人花一整月在迁移 prompt,自我感觉高产,实际交付并没有变多。
每个版本我都干过。最尴尬的一次是 GPT-4.5 前后——我花了将近一周重写本来运行良好的 prompt,去追大概 5% 的提升,而它们所服务的那个项目一丁点新产出都没有。那次失败其实是很有用的信息。
这个模式是:能复利的工具,是你用来生产的那些,而不是用来配置工具的那些。
在 GPT-6 到来之前该建好什么
好,这才是我真正在意的部分。如果你经营一人业务,而 GPT-6 明天就发——或者三个月后——你这边应该已经存在些什么?
现在就把你的重复性工作标准化
最能从更好模型中受益的工作,是输入输出都清晰的重复性工作。研究简报。初稿大纲。代码评审。客户邮件草稿。周报摘要。
如果这些工作活在脑子里或散落在各种 prompt 里,更好的模型只会给你一堆散落的更好输出。如果它们以文档化工作流的形式存在、输入清晰——这是源材料,这是受众,这是格式,这是一个好例子——那么你可以换进一个更好的模型,第一天就获得真实的提速。
我一直在慢慢把自己重复性的东西,每条工作流整理进一份简单的文档。不花哨。输入格式、prompt、好的输出示例、坏的输出示例。每条工作流花一小时,第一次用新模型跑它就回本。
构建能迁移到任何模型的上下文体系
这是更大的那件事,也是 Altman 关于记忆的评论真正起作用的地方。
GPT-6 正朝着持久化、个性化的助手走去——模型了解你的工作、你的项目、你的写作声音。但关键在于:这只有当你能清晰回答"我的工作、我的项目、我的写作声音是什么"时才成立。
大多数单人创业者答不上来。他们的上下文散落在 Google Docs、Notion、Slack、邮件和随手记的文本文件里。当模型提出"记住你是谁"时,它只能记住你递给它的东西。
现在值得做的功课:
-
写一份一页纸的文档,描述你做什么、服务谁、目前在做什么、喜欢怎么沟通。这是任何助手——现在的或未来的——的"前上下文"。GPT-5 开发者页面展示了结构化指令如何实质性地改善输出——无论模型是 GPT-5、GPT-6、Claude 还是下一个发布的东西,这一点都成立。
-
按工作类型维护一份"你最好的输出"的持续文件——那些你引以为豪的邮件、跑出成绩的简报、你愿意再写一遍的代码。这会成为任何模型的风格参考。
-
把你反复做的决策以及 为什么 记下来。不是"怎么写落地页",而是"我认为什么样的落地页算好、为什么"。
这些都不需要 GPT-6。所有这些都会让 GPT-6(或 Claude,或其他任何东西)上线当天立刻变得有用。
我希望自己两年前——甚至早在 GPT-4 之前——就做过的一件事:花一个周末,把那些我早就知道答案的问题写下来。自从我开始这么做,每个助手都变得更好用了。
总之——这就是我目前对这件事的立场。等模型真正发布,我会再来更新。
延伸阅读
→ 看看为什么没有结构,大多数 AI 工作流都会崩(以及如何在 GPT-6 之前修好它)
→ 理解**持久化 AI Agent 是什么、为什么记忆会比模型升级更重要**
→ 了解 2026 年 AI 到底怎么融入单人创业者的工作流(撇开炒作)
→ 探索如何**构建不靠招人也能扩大一人业务的系统**
→ 拆解 AI 为什么**每次会话都会「失忆」——以及现在该怎么做**
常见问题
### GPT-6 什么时候发布? 截至 2026 年 4 月底没有官方日期。OpenAI 于 3 月 24 日完成预训练,Altman 说发布「还要几周」,而截至撰稿,旗舰模型仍在安全评估中。综合公开信号的最佳猜测:2026 年 Q2 末或 Q3。关注 OpenAI 官方公告,而不是泄露消息或 Twitter。
### 更强的模型会自动让我更快吗? 不会自动变快——这正是 GPT-4→5 那轮发布留下的核心教训。更好的模型只加速「生成」这一步,而它只是更长链条里的一环:想清楚要什么、准备上下文、生成、复核、交付,其余步骤该多慢还是多慢。实际体感:已有成熟工作流的任务大约快 15%,没有工作流的任务为零甚至为负。
### 要不要等 GPT-6 发布再动手搭建? 不用等。让 GPT-6 有用的功课——文档化的工作流、清晰的工作画像、风格参考、写下来的决策——和让当前模型更有用的是同一批,它会跨代复利。等待只会推迟你本来就需要搭的脚手架;每次新模型发布时获益最大的,都是提前把系统备好的人。
https://floatboat.ai/zh/blog/openai-gpt-6-one-person-company