
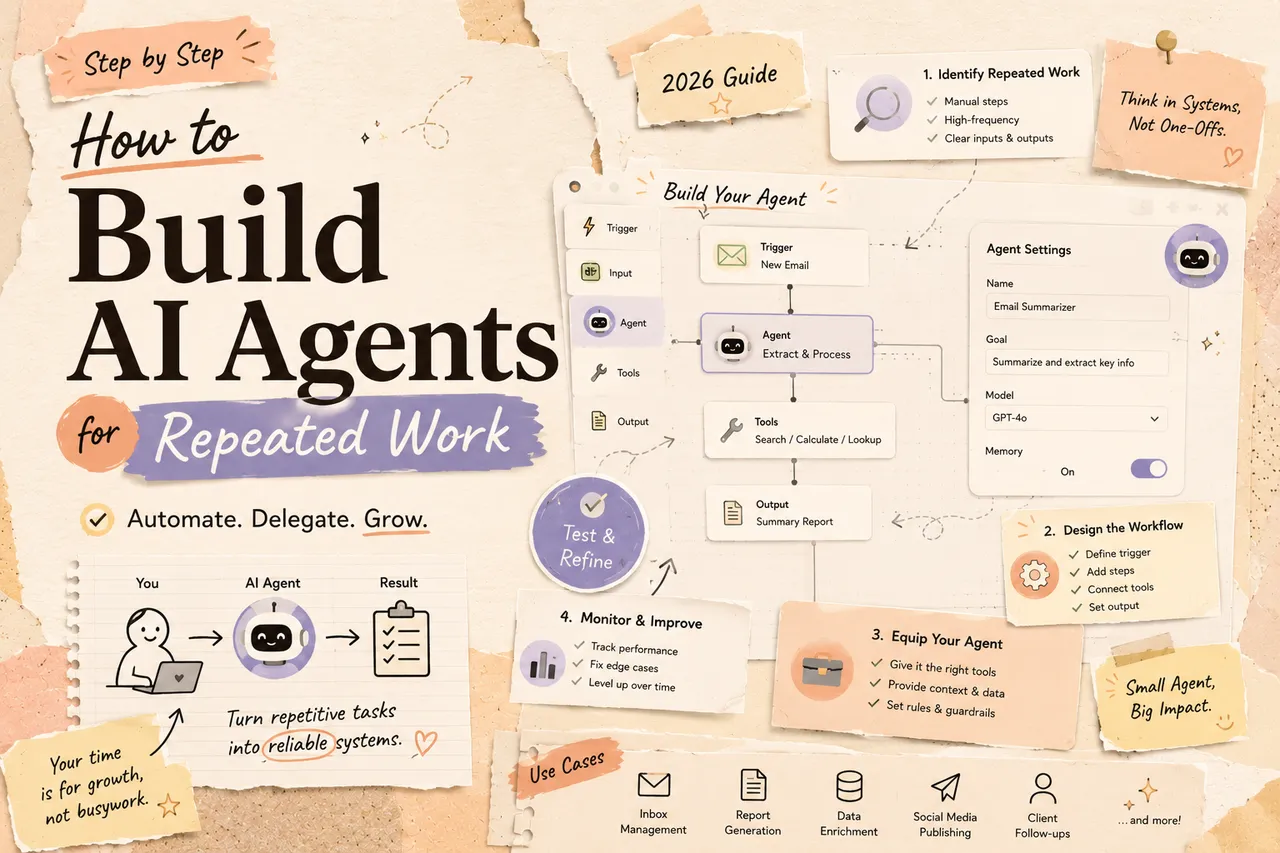
为重复工作构建 Agent,目标不是追求最大自主性,而是做出一个最小系统:完成边界清楚的任务、展示证据、不越过权限,并在现实情况不符合指令时安全停止。
下面用“把客服工单变成有分类、有证据的回复草稿”贯穿全过程。同样的方法也适用于文档接收、线索补全、会议后续、周报整理等重复工作。
动手前:先判断是否真的需要 Agent
Anthropic 将两类系统分开:workflow 的路径由代码预先决定;Agent 则由模型动态选择步骤与工具。其构建有效 Agent 的官方指南建议从最简单的可行方案开始,因为 Agent 的灵活性会带来额外时延、成本和错误累积。
按以下顺序判断:
- 模板或规则:输入与转换完全可预测。
- 单次模型调用:需要理解,但不需要外部动作。
- 包含 AI 步骤的确定性流程:路径固定,模型只负责分类、提取或起草。
- Agent:步骤数量或顺序无法预先确定,需要模型在工具间选择。
- Agent Workspace:工作具有探索性,人需要持续检查来源、中间文件和变化中的成果。
客服回复通常只需要第三层。触发、客户查询、政策查询、schema 校验和审批都可以确定化;模型负责分类与起草。只有固定检索路径确实不够时,才需要开放 Agent 的工具选择。
第一步:选择有明确验收终点的任务
合适的任务有可重复输入、稳定目标、可验证结果、能够收窄权限的工具、可逆的早期输出,并且工作量足以覆盖长期维护成本。
“处理客服”太宽。“遇到计费类工单时,读取客户与发票,选择适用政策,生成带依据的回复草稿,交给客服批准”才可以构建。
如果成功依赖说不清的品味、责任人互相冲突、动作不可逆,或权威事实无法可靠取得,不应把它作为第一个 Agent。
第二步:写任务契约
选择框架前,先把运行契约写清楚:
| 契约字段 | 客服草稿示例 |
|---|---|
| 触发条件 | 新工单被标记为 billing |
| 必需输入 | 工单正文、客户 ID、发票 ID |
| 允许来源 | CRM、账务系统、获准政策库 |
| 允许工具 | 读取客户、读取发票、检索政策、创建草稿 |
| 输出 | JSON 分类与带证据链接的回复草稿 |
| 审批 | 客服批准后才能发送 |
| 停止条件 | ID 缺失、记录冲突、无适用政策、疑似欺诈 |
| 禁止动作 | 发送、退款、删除、修改账户权限 |
这份文档既是 Agent 的边界,也是测试依据。将它保存在版本控制或其他稳定系统中,不要只留在某个搭建器界面里。
第三步:把工具设计成窄契约
工具连接的是非确定性模型与确定性系统,因此需要明确名称、用途、输入与输出 schema、错误行为、权限范围、超时和审计记录。
优先使用“按 ID 读取发票”而不是任意数据库查询;使用“创建回复草稿”而不是通用邮件工具;使用“请求退款复核”而不是直接退款。
Anthropic 的工具设计指南指出,功能重叠或含糊的工具会增加选错概率。工具返回应只包含下一步需要的上下文,同时保留稳定 ID 与来源时间,便于审计。
每个写工具还应明确幂等性。同一个调用因重试到达两次时,不能生成两笔退款、两项任务或两封邮件。
第四步:分开指令、上下文与状态
- 指令定义工作、规则与输出格式。
- 上下文是当前判断需要的高信号信息。
- 状态记录本次运行以及跨运行已经发生的事情。
不要每次把整个知识库塞进上下文。检索相关政策,记录它的 ID 和版本,只传入完成判断所需的最小片段。Anthropic 的上下文工程指南强调高信号上下文,并提醒避免膨胀、含糊的工具集合。
状态至少应包含 run ID、输入版本、已完成步骤、工具结果、待审批项、最终结果和副作用 ID。只有这样,操作者才能检查并恢复失败运行。
第五步:让审批发生在后果之前
| 动作等级 | 示例 | 默认处理 |
|---|---|---|
| 读取 | 查询工单或政策 | 在权限范围内允许 |
| 草稿 | 创建回复或候选任务 | 允许、记录并复核 |
| 可逆写入 | 添加标签或草稿记录 | 通过试点控制后开放 |
| 高影响写入 | 发送、发布、付款、删除、修改权限 | 必须显式审批 |
审批必须发生在工具调用之前,向复核者展示动作与证据,设置过期时间,并记录审批人。拒绝或超时之后怎么处理,也要提前定义。
工单、邮件、文档与网页中的内容都属于不可信数据,其中可能夹带试图改变 Agent 行为的指令。来源文本不能覆盖系统规则或工具权限。
第六步:实现最小执行循环
- 校验输入。
- 加载任务契约与当前状态。
- 只检索相关上下文。
- 要求模型以结构化格式提出下一步。
- 用策略校验工具及参数。
- 执行,或暂停等待审批。
- 记录事件与结果。
- 持续到成功、安全停止或达到预算。
- 最后运行确定性校验器。
设置最大轮次、工具调用次数、超时与费用上限。带清楚原因的停止是有效结果;无限重试不是韧性。如果路径本来就已知,应把它实现为 workflow,而不是让模型每次重新发现。
第七步:上线前建立评估集
使用历史案例覆盖正常工作与失败边界,包括 ID 缺失、重复事件、记录冲突、过期政策、工具不可用、来源文本中的提示注入、越权请求、中途被打断的运行,以及读取后写入前发生变化的数据。
每个案例要写明预期事实、允许动作、禁止动作与验收标准。Anthropic 的Agent 评估指南强调检查完整轨迹——包括工具调用和状态变化——而不只是最终答案。
分别衡量任务正确率、证据完整性、工具与参数选择、禁止动作尝试率、人工修正时间、恢复后是否重复产生副作用,以及每个合格结果的时延与成本。不存在通用的“安全准确率”,要求多高取决于错误后果与人工复核。
第八步:分阶段部署
先离线评估,再进入 shadow mode:Agent 处理真实输入但不产生外部写入。之后只开放草稿或另一项可逆动作。最后才考虑高影响工具,而且仍应有显式审批。
每次失败都应分类:输入错误、上下文缺失、指令含糊、工具选错、工具故障、权限拒绝、模型错误或校验器不足。换模型只对其中部分问题有效。
第九步:让每次运行可观察
生产运行必须能回答:使用了哪个版本的输入与指令;何时从哪里检索了什么;提议和执行了哪些工具与参数;工具返回什么;审批发生在哪里;运行为何停止;以及花费的时间和成本。
为反复重试、工具错误激增、审批积压、成本异常、会话停滞和越权尝试设置告警。成功运行也要抽样检查,因为系统可能在 HTTP 200 的同时发生质量漂移。
第十步:提前设计失败恢复
定义瞬时错误的重试规则、dead-letter queue、checkpoint 与续跑行为、写入动作的幂等键、回滚方法、包含状态与证据的人工接管包,以及禁用工具或整条流程的 kill switch。
恢复能力必须主动测试:分别在读取后、审批后、写入前后中断运行;在执行中轮换凭据;重放相同触发事件。系统应默认关闭风险,并避免重复后果。
什么时候不该构建 Agent
任务契约每一步都只能写“视情况判断”、没有权威数据、无人负责审批与事故、唯一工具权限过大、输出无法评估、任务变化快过维护速度,或收益无法覆盖复核和运营成本时,应停止或选择更简单的方法。
固定的跨应用流程可使用 workflow builder,可参考无代码 Agent 搭建器选型指南。需要人持续改变方向、处理大量工件的任务,可阅读工作流搭建器与 AI Workspace 的比较。若要理解执行层,再看什么是 Agent Harness。
生产就绪检查表
- 有明确的任务负责人和运行负责人
- 任务契约与工具 schema 已版本化
- 使用最小权限凭据
- 高影响动作之前有审批
- 评估集覆盖正常与对抗输入
- 日志包含来源与副作用 ID
- 已测试重试、续跑、回滚与 kill switch
- 看板覆盖质量、介入率、成本和时延
- 定期审查政策、连接器、模型与提示变化
完整构建顺序并不神秘:收窄任务、正式写下契约、开放小工具、管理状态、插入审批、评估执行轨迹、分阶段部署、观察每次运行,并演练恢复。这才是把重复工作变成可运营 Agent,而不是把生产凭据接到一条提示词上。
相关文章
Gemini Agent 是什么?Google 通用工作 Agent 详解
Gemini Agent 是 Google 面向企业工作的通用 Agent,支持持久执行、多 Agent 协作、多模型路由和业务工具连接。本文解释它与 Gemini App 的区别、核心能力、开放状态及现阶段限制。
AI Agent Connector 详解:MCP、OAuth 与权限边界
从实际工作流解释 AI Agent Connector 如何组合 MCP、OAuth、Scope、资源权限与人工审批,并提供选型、试运行、故障定位和安全核查方法。
Agent Harness 是什么?从执行循环到安全恢复
系统解释 Agent Harness 的架构:执行循环如何连接上下文、工具、沙箱、权限审批、可观测性与失败恢复,以及如何区别模型、Framework、Connector 和 Workspace。
https://floatboat.ai/zh/blog/how-to-build-ai-agents-for-repeated-work