
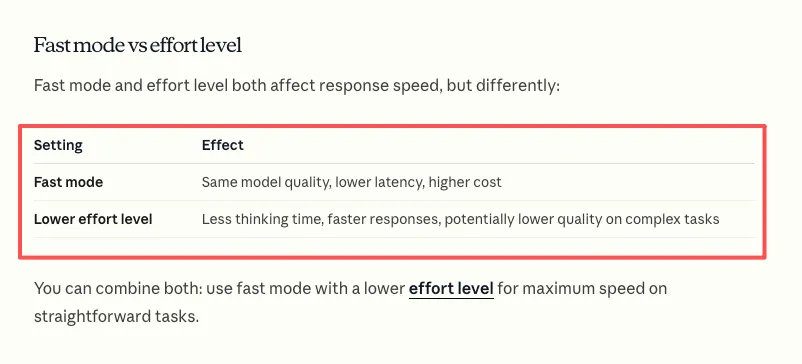
现在的 AI 工作有两只不同的“速度旋钮”。Effort 决定模型投入多少推理;Fast Mode 决定受支持模型以多快的速度输出。降低 Effort 可能用较少分析换取更低延迟与成本;Fast Mode 则通常以更高价格换取更快输出。
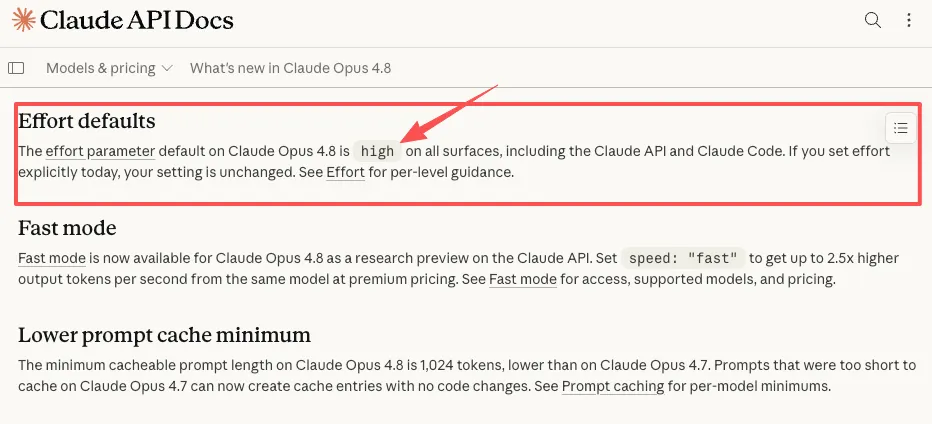
截至 2026 年 10 月 13 日,Anthropic 为部分模型提供从 low 到 max 的 Effort 档位,并把 Fast Mode 标为部分 Opus 模型可用的 Research Preview。其模型选择指南称,Fast Mode 的输出速度最高可提高 2.5 倍,但支持范围取决于模型、平台、账户权限和最新文档。下面给的是任务分流框架,不是“某个档位永远最好”的结论。
先把推理投入和响应速度分开
| 任务条件 | Effort 起点 | 速度起点 | 原因 |
|---|---|---|---|
| 后果低、重复多、容易验收 | Low 或 Medium | Standard | 不为用不到的分析付费 |
| 后果低,但等待会卡住人 | Low 或 Medium | 有权限时用 Fast | 响应速度有直接价值 |
| 后果高,有明确证据和验收标准 | High 或 xhigh | Standard | 先保证推理质量 |
| 后果高且真正有时限 | High 或 xhigh | Fast,之后人工复核 | 只在等待成本明确时购买速度 |
“重要任务”这个标签不够用。一封客户邮件可能很重要,但认知难度很低;一个可回滚的内部分类决策,反而可能需要深入推理。Effort 要看歧义与错误后果,速度要看等待成本。
Effort 到底改变了什么
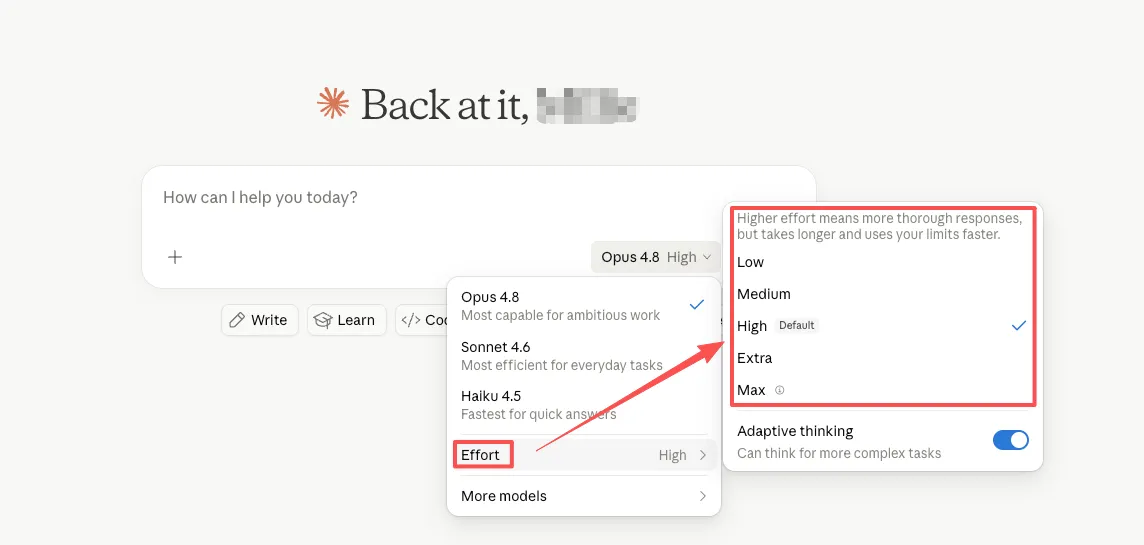
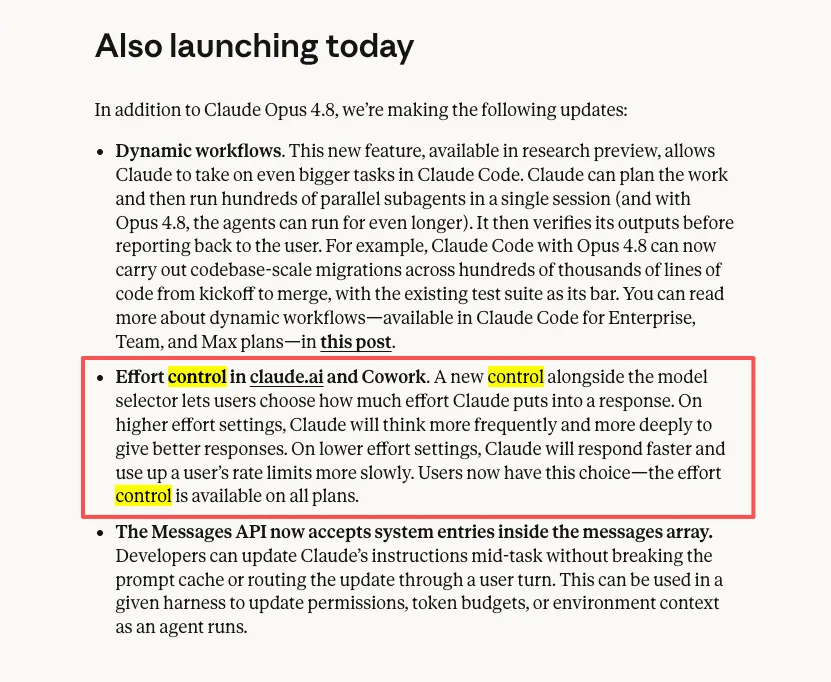
Anthropic 的提示词指南说明,Adaptive Thinking 模型会同时参考 Effort 档位与问题复杂度来分配推理。提高 Effort 可能带来更完整的分析,也可能增加延迟和 Token 消耗;它无法弥补缺失的证据、模糊的说明或不安全的工具权限。
抽取、格式转换、分类这类有确定校验方式的任务,可以从 Low 开始。普通写作与比较可从 Medium 开始。只有在多重约束、复杂诊断、长链计划或错误代价较高时,再考虑 High、xhigh 或 max。不同模型支持的档位并不完全相同,固化工作流前应核对对应模型页面。
Effort 只有配合验收标准才有意义。“更认真地想这个策略”只增加空间,没有增加方向;“按现金风险、可逆性和 30 天落地约束排序三个方案”才让额外推理可以被检查。
什么时候 Fast Mode 值得付费
Fast Mode 是服务速度选择,不是降低质量的快捷键。Anthropic 的发布记录将其描述为以溢价换取更快输出,而且支持范围按模型逐步扩大。若要把速度写进客户承诺,必须先核对当前价格和权限。
以下场景最容易算清价值:
- 人正在等待交互式调试、编辑或客服草稿;
- 多个 Agent 步骤必须串行执行,每一步延迟都会叠加;
- 截止时间有明确业务成本;
- 快几分钟就能让下一位执行者立即开工。
夜间研究、批量分类、定时报表或本来就要排队复核的任务,通常不需要 Fast Mode。如果结果六小时后才有人看,更快生成并没有创造价值。
一套不随模型版本失效的分流方法
不要只按“研究”“写作”“编码”分流。每个任务先问四个问题:
- 答错的代价多大? 把返工、声誉、金钱和权限风险都算进去。
- 结果多难验证? JSON Schema 很容易查,战略预测则很难。
- 等待是否卡住人或后续步骤? 如果没有,速度的边际价值就很低。
- 能否拆成不同阶段? 先用低成本阶段整理证据,再把高投入留给决策。
内容流程可以用 Low 统一笔记格式,用 Medium 生成大纲,用 High 解决来源冲突,再让夜间终稿保持 Standard 速度。成熟的 Vibe Coding Agent 工作流也是同一逻辑:把更强推理放在不确定的关口,而不是机械步骤上。
衡量“可接受产出”,不要只看模型表现
从真实工作中抽取 10—20 个代表性任务,记录从提交到结果被接受的总时间、输入与输出成本、修改次数、事实或约束错误、人工复核分钟数,以及结果最终有没有采用。
不要只比较首 Token 延迟或 Benchmark。一个生成很快、却需要十五分钟修补的草稿,可能输给较慢但一次通过的版本;Max Effort 增加无人需要的润色,同样是浪费。
测试时一次只改一个变量。先在 Standard 速度下比较不同 Effort,再在胜出的档位上测试 Fast Mode,才能区分推理深度变化和服务速度变化。
五个常见误区
所有任务默认拉满。 只有低档位违反了明确验收标准,才升级。
把 Fast 当成紧急标签。 “尽快”不等于延迟就是瓶颈;先找下一项依赖动作和真实截止时间。
用高 Effort 补证据不足。 再多推理也不能验证无来源事实。应提供一手资料并要求引用。
忽略人工复核能力。 生成速度提高后,审批可能积压;两者要一起调。
把流程绑死在单一厂商功能上。 分流规则应写成“低风险抽取”“高风险综合”“延迟敏感交互”,这样模型更新后仍能迁移。一人公司 AI 工作流指南进一步说明了如何搭建这些可复用阶段。
原文视觉资料
以下图片恢复自文章最初发布版本,用于补充界面、流程或对比语境。涉及产品界面、价格、基准结果和模型可用性的画面属于历史记录;做当前决策前,请以厂商最新官方信息为准。
可执行的默认值
日常、可回滚任务先用 Medium Effort 与 Standard 速度。若验收稳定,再降低 Effort;若出现明确记录的推理失败,再升级。只有等待会卡住人或后续动作时,才打开 Fast Mode,并用实际节省的时间重新核算溢价。
目标不是让模型尽可能多想或尽可能快说,而是把推理和速度花在真正改变最终结果的地方。
相关文章
GPT-6.1 Sol 详解:价格、性能、开放范围与模型对比
GPT-6.1 Sol 以 Astra 五分之一的标准 token 价格,提供接近 Astra 的编程、电脑操作与专业工作能力。本文解释这些数字真正意味着什么。
Jev 是什么——不生成文本的决策模型
Jev 是 TypeSafe AI 发布的 System One 模型:读取状态、返回带置信度的 typed decisions,而不生成任何文本。本文拆解其 RLCD 训练方法、官方宣称的 193.6x 加速与 444.6x 成本优势,以及 Hacker News…
DeepSeek V4.1 Flash:正式版状态、规格、价格与迁移
DeepSeek V4.1 Flash 已成为正式 Flash 模型。本文核对生产模型名、1M 上下文、视觉能力、峰谷价格、退役别名、V4 Pro 临时路由,以及从限时测试版迁移时必须复测的关键项目。
https://floatboat.ai/zh/blog/effort-control-fast-mode-ai-work