ChatGPT 语音模式 vs 听写 — 什么时候该开口说、什么时候该转成字
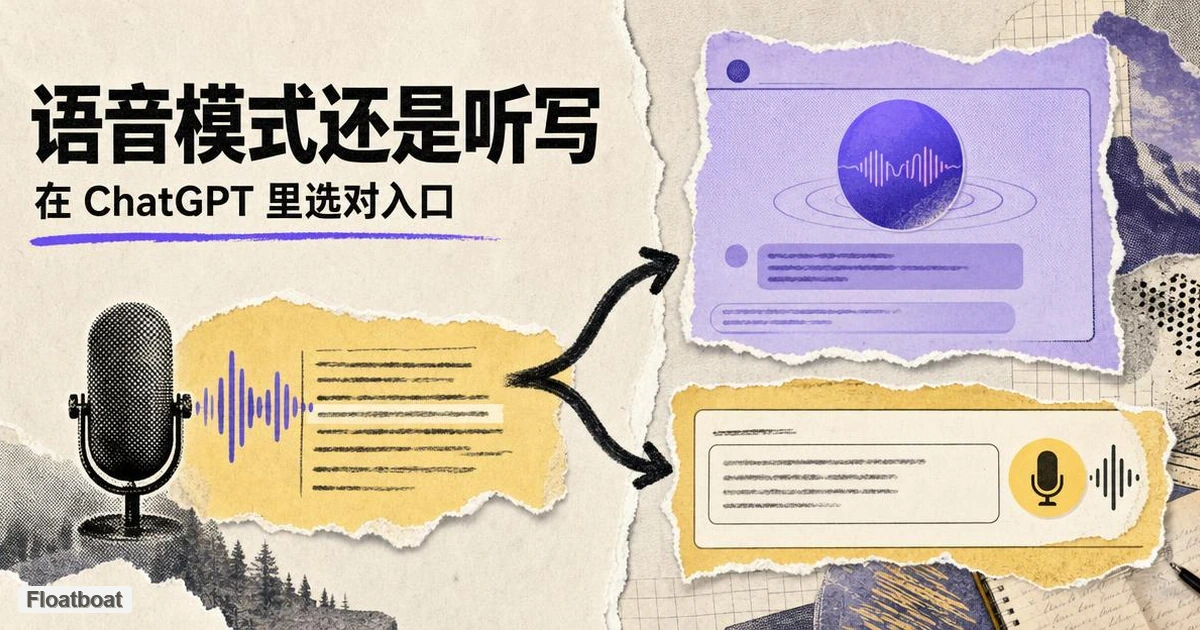
ChatGPT 的语音模式与听写不是一个功能的两个名字:语音模式(波形图标)由 GPT-Live 模型家族驱动,是实时双向语音对话;听写(麦克风图标)把语音转成输入框里可编辑的文本,发送前可审阅修改。本文梳理语音输入的四代演进、七维对比表、面向 Agent 工作流的选型建议,并回答额度、长提示词与文档听写等常见问题。
1. AI 正在解决的语音输入问题
如果你过去一年在手机、笔记本或桌面应用上打开过 ChatGPT,你几乎肯定注意到两个与麦克风相关的入口——而且很多人把它们当成一回事。它们不是。一个开启实时语音对话,ChatGPT 以音频回话,转写在线程里累积。另一个用文本填满消息框,你可以在点发送之前编辑、删除、重写。同一个应用、很多情况下底层是同一个模型家族,但它们与你的注意力、你的双手、你的下游工作流签订的是不同的契约。
在语音不再是挂在聊天上的新奇功能之后,这个区别变得更加重要。OpenAI 报告每周有超过 1.5 亿人使用 ChatGPT 语音与听写(MarkTechPost 对 GPT-Live 发布的报道),2026 年年中的桌面体验以 GPT-Live 为核心——一个能同时听与说的全双工语音模型家族,可以处理打断,并把更深的推理委托给 GPT-5.5 这类模型,同时保持对话不断线。与此同时,听写仍是一条语音转文本路径,通向你平时打字用的同一个 composer——而这恰恰是多数 agent 工作流需要的:目标是一条精确的指令,不是一场口头研讨会。
这种混淆情有可原,因为两个功能都住在 composer 区域、都接受语音、在营销里都叫「跟 ChatGPT 说话」。OpenAI 之外的产品团队放大了模糊:系统级听写工具、会议记录器与独立语音 agent 各自用重叠的词汇解决相邻的问题。对一个正在起草客户提案的独立创始人、一个在定义多步 agent 运行的运营者、或任何把语音接进日历驱动技术栈的人来说,选错的后果不是「AI 不行」——而是模态错了。你要么在提示词发出之前失去了控制权,要么失去了让语音对话值得占用音频通道的那种流畅感。
想看品类层面的框架——听写与 voice agent、voice mode、agent 系统里的环境捕获有什么不同——参阅我们的面向 AI Agent 的语音听写定义。本文聚焦 OpenAI 的两条应用内路径,以及各自何时适合最终要落进 agent、文档或排定任务的工作。
2. AI 语音输入的四个世代
在并排比较 ChatGPT 的两个图标之前,先把它们放进一张简短的演化图。AI 产品里的语音输入走过了从哑转写到逐轮语音聊天再到全双工对话的路线,其间还有一条从未离开文本框的文档原生听写平行线。ChatGPT 同时搭载着多个世代的样本;搞清世代,你就知道每条路径当初是为解决什么问题而造的。
2.1 第一代:OS 与输入框听写(语音 → 光标)
最老的一层是操作系统听写与第三方语音转文本:你说话,文字出现在光标处,没有任何东西回话。Mac Dictation、Windows 语音识别与 Wispr Flow 这类工具在此称王。它们快、不挑套餐、不挑应用——这就是为什么很多高级用户在正经写作时从不碰 ChatGPT 的内置麦克风。局限同样清楚:转写步骤的另一侧没有模型、没有对项目的记忆、也没有 agent 上下文,除非你把结果粘贴到有这些上下文的地方。
2.2 第二代:Composer 听写(语音 → 可编辑提示词)
ChatGPT Dictation 属于这一代。点消息 composer 里的小麦克风图标(不是波形图标),说话,得到框内可编辑文本。你改掉听错的名字、补上一条忘了说出口的约束、粘贴一段别处的代码,然后发送——和发送一条打出来的消息一模一样。OpenAI 的帮助文档明确把 Dictation 定位给想「录一条提示词、审阅并编辑其转写、再按文本发送」的用户。在 ChatGPT 套餐上这条路径不占用单独的 GPT-Live 额度;语音这一步是转写,不是语音对话会话。这使第二代听写成为长 agent 提示词、工具调用指令以及任何「一个坏 token 就毁掉整次运行」的场景的默认输入方式。
2.3 第三代:逐轮语音聊天(语音 → 模型 → 语音回复)
ChatGPT 的 Standard 与 Advanced 语音体验位于第三代。你的语音被转写,模型推理,然后播放语音回复——轮次分明、边界清晰。Standard 特别适合嘈杂房间或想完整说完一个想法再听答案的人。Advanced 增加了符合条件的视觉共享等依赖账号的能力。交互是对话式的,但轮替仍是主导隐喻:你说,然后等,然后 ChatGPT 说。对头脑风暴与无障碍场景,这已经比打字前进了一大步;但对 agent 编排,它常常是错的形态——因为你要的交付物仍是一条结构化消息或文件,不是一段之后还得提炼的音频交流。
2.4 第四代:全双工语音模式(GPT-Live / Live)
由 GPT-Live 驱动、带 Live 选项的 Voice Mode 是第四代。模型可以边听边说、接受打断、使用附和语(「嗯」「明白」),让整个交流感觉像打电话,而不是 STT → LLM → TTS 的三段接力。OpenAI 在 2026 年大范围推送 GPT-Live;付费套餐使用 GPT-Live-1,免费档可能看到限额更紧的 GPT-Live-1 mini。Live 可以用网络搜索、记忆、受支持的可视化组件,并在同一聊天里处理文本与图像——不过在 Live 初次上线时,视频、屏幕共享与连接的应用不受支持,见 OpenAI 的 Voice 帮助页。语音转写会出现在线程里,但 OpenAI 警告它们并非逐字记录所有内容——如果你把语音会话当成 agent 任务的权威规格,这一点很关键。
第四代还包括聊天线程之外的一条平行分支:文档中心听写——语音喂给一份活草稿,agent 在原位协同编辑。这条分支正是包括 Floatboat 的 Flow Mode 公告在内的互补工具所优化的方向,而不是去取代 ChatGPT 里的第四代对话。
3. 正面对决:ChatGPT 语音模式 vs 听写
ChatGPT 在 UI 里就把产品分岔摆在了明面上:波形图标 → Voice Mode;麦克风图标 → Dictation。其余一切——套餐限制、模型路由、能不能打断、发送前能不能编辑——都由这个分岔派生。下面的对比有意限定在 OpenAI 自己的两条路径上,外加一行参考,标注聊天 composer 工作流力有不逮时的文档原生听写。
3.1 对比表
下表压缩了团队评估语音用于 agent 与知识工作时反复出现的七个维度。单元格做了简化;套餐细节会变——把限制当作截至 2026 年 8 月的信息,正式铺开前请对照 OpenAI 当前的帮助页面核实。
| 维度 | ChatGPT Voice Mode(GPT-Live / Live) | ChatGPT Dictation | Floatboat Flow Mode(文档听写) |
|---|---|---|---|
| 交互模型 | 双向语音对话;模型以音频回话 | 单向语音 → 文本;发送前没有语音回复 | 语音 → 活文档;Agent 在同一文件里协同编辑选中片段 |
| 主要输出 | 音频回复 + 非逐字的线程转写 | Composer 里可编辑的文本,作为普通聊天消息发送 | 带版本历史与 diff 的持久文档 |
| 「提交」前的控制 | 低——语音即对话;没有 composer 审阅步骤 | 高——审阅、编辑、追加,然后发送 | 高——边说边改;Agent 运行前打包语音批注 |
| 用量限制 | 视套餐而定的 GPT-Live 额度;付费桌面端为滚动窗口(如 Plus 级套餐的五小时桶);免费档严格配给 | 无单独语音分钟上限;消息计入常规套餐限制 | 绑定 Floatboat 工作区用量;不占 ChatGPT GPT-Live 额度 |
| 最适合 agent 工作流 | 澄清模糊目标;探索式对话;免提的状态问答 | Agent 任务提示词、工具 schema、结构化指令、可直接粘贴的规格 | 长文文档、会议转行动项草稿、以文件为运行时的日历挂接准备 |
| 同一会话内的多模态 | Live 支持搜索、记忆、图像、组件(视账号而定);Live 上线时无视频/屏幕共享 | 发送后与打字聊天一致——文件与图像可随消息附上 | 事件工作区内语音 + Agent + 会议捕获 |
| 短板 | 难以保证提示词逐字精确;转写非逐字;消耗语音额度 | 无语音来回;2026 年有移动端自动发送 bug 报告;仅限 composer | 不替代 ChatGPT 的通用推理聊天;另一个产品界面 |
Voice Mode 在它被造出来的那份工作上值得肯定。在 Mac 与 Windows 桌面应用里,你可以在 设置 → Voice 下开启新的语音聊天或绑定快捷键。Live 的全双工行为——打断、语音重叠、推理深度选择——让它在对话速度胜过文本精度时成为应用内最强选项。Dictation 在相反的轴上同样值得肯定:当你本来要打三段话的 agent 简报、只想让手腕先下岗、等文本上屏再说时,用的就是它。
Floatboat 这一行不是与 ChatGPT 对打的「赢家」;它标记的是一条互补车道。很多运营者用 ChatGPT Dictation 起草提示词、用 Voice Mode 出声压测假设,再在交付物必须活得比聊天线程久——客户备忘录、SOP、挂接日历事件的会议计划——时切到文档原生层。如果你想比较的是跨产品的语音模态而不只是 OpenAI,我们的面向 AI Agent 的语音模式与语音听写对比讲跨厂商框架;本文只谈 ChatGPT 的两个图标。
3.2 Voice Mode 有而 Dictation 没有的
GPT-Live 这套栈的存在,是因为逐轮语音仍然像对讲机。全双工聆听意味着你可以在句子中途澄清、在意识到模型误解时掐断跑题、或要求放慢语速而不必结束会话。OpenAI 2026 年的人类评估显示,在流畅度、打断与自然度上,用户明显偏好 GPT-Live 而非 Advanced Voice Mode——这类主观指标关联的是持续的口语使用,而不是一次性听写。
对接近 voice agent 的工作——持续循环、语音反馈、低延迟——Live 更接近我们 什么是 voice agent 枢纽文章描述的架构:感知与回应在同一个会话里,而不是转写一跳之后、再由你手动触发的独立推理步骤。对 agent 构建者来说,坑在于 ChatGPT Voice Mode 最终止步于聊天转写,而不是进入你可控的工具执行。你可以出声让 ChatGPT 起草一份 agent 规格,但你是在和一位通用助手谈判,不是在把结构化任务派发给你自己的运行时。会话结束后,你往往要向前复制文本、或重新口述重要的部分——这正是第二代听写仍是大多数团队实际在用的桥梁的原因。
3.3 Dictation 有而 Voice Mode 没有的
Dictation 保全了 agent 工作流赖以运转的 composer 契约。Agent 提示词是脆弱的:一个错的参数名、一条缺失的护栏、一个含糊的代词,都可能浪费一整次运行。Voice Mode 优化的是对话式修复——你一直说到对齐为止——但它不给你一个模型消费你的意图之前的、静态可编辑的产物。Dictation 给。你看到 token 边界,改掉同音词,插入代码围栏,粘贴 JSON,然后才提交。
这种发送前审阅也是听写在长任务上扩展性更好的原因。Voice Mode 里十分钟的口述,产出的是一份你反正还要重读的转写;同样十分钟的独白通过听写进 composer,已经是下游工具期待的形状。2026 年的外部基准与用户报告一致建议:凡涉及具体约束、人名、数字或利害关系的内容都用听写——这些话直接对应 agent 触发器、CRM 更新与挂接日历的指令。Voice Mode 的独立额度则是反方向的现实 tiebreaker:如果你的 GPT-Live 分钟数吃紧,用听写起草不会消耗那个池子。
4. 怎么为 Agent 工作选对语音工作流
在 Voice Mode 与 Dictation 之间做选择,关键不是哪个功能「更聪明」,而是提交点在你的工作流里落在哪。Agent 工作引入了第二根轴:这次会话产出的是可执行文本、探索式对齐,还是一份比聊天活得更久的持久文档?
如果你的管线是「人定义任务 → agent 执行 → 人审阅输出」,定义这一步几乎总是想要听写或打字。你在构建一份契约:范围、允许的工具、成功标准、边界情况。Voice Mode 可以帮你发现契约里该有什么——把边界情况聊透、听到模型提出澄清问题——但契约本身应该先落成可编辑文本,再去触碰生产 agent。跳过这一步的团队常报告返工:一句被模型在转写里转述得不一样的口语,变成了错误的触发条件。
如果你的管线是「人出声思考 → 模型回应 → 人实时调整方向」,Voice Mode 是更好的选择。事后还在脑内回放的客户访谈、语言辅导、演练提案,或在需要听到语气与节奏的决策树里走一遍——这些都是第四代的活儿。它们可能仍间接喂给 agent 工作(你结束会话后听写一份总结),但会话本身不是 agent 触发器。
混合模式在独立创始人中很常见。一个典型节奏:先用 Voice Mode 攻五分钟一个模糊问题,结束会话,开一个新 composer,把学到的东西听写成一条干净的提示词,然后把它粘贴或路由到你真正在用的 agent 平台。另一个节奏:完全用听写写提示词、直接发送,只有当回复暴露出值得口头掰扯的困惑时才切到 Voice Mode。两种节奏都尊重模态分工,而不是逼一个图标干两份活。
对文档中心的工作——提案、要变成任务清单的会议记录、多章节简报——聊天 composer 听写很快触顶。你仍在聊天与文件之间来回复制、丢失选区上下文、每次会话重建工作区状态。这正是文档原生听写瞄准的缺口。Floatboat Flow Mode 把语音、手动编辑与 Agent 改写留在同一份文档里,批量语音批注与实时会议产出以清单形式落地,而不是事后转写。它补充 ChatGPT 而非取代:许多人把 ChatGPT 留给开放式推理,让 Flow Mode 处理必须赶上日历截止的那份产物。今天两条 ChatGPT 路径都没有为「文件即运行时」优化;选择 Flow Mode 是工作流选择,不是对 GPT-Live 质量的判决。
拿不准时,按这个决策顺序走:(1) 在任何东西执行之前,我需要精确的文本吗? → 听写。(2) 语音来回本身就是交付物吗? → 语音模式。(3) 产出要活在一份带修订历史与日历上下文的文档里吗? → composer 之外的文档原生听写。(4) 我在搭建常开自主语音循环吗? → 那是 voice agent 的地盘,ChatGPT 哪个图标单独都不够。
5. 语音优先 AI 工作流的下一步
2026 年年中 OpenAI 的方向很明确:点语音时默认进 GPT-Live,公司把全双工对话定位为主流体验,同时保留 Standard 与 Advanced 路径给想要更清晰轮次边界或旧有行为的用户。GPT-Live 的 API 开放计划在消费端铺开之后,将让开发者把同样的对话体验嵌入 ChatGPT 外壳之外——只要构建者自己解决鉴权、工具使用与记忆,就可能模糊「Voice Mode」与独立语音 agent 的界线。
听写不太可能消失或与 Voice Mode 合并,因为 composer 仍是一切将要变成代码、配置或 agent 指令的东西的最小控制单元。如果有什么变化,预期是听写与项目的更紧集成:更长的提示词、文件感知的 composer、以及更好的移动端可靠性——让麦克风图标在经历了 2026 年初的自动发送问题之后,在手机上重新值得信任。跨应用听写层将继续在个人词表与按应用格式化上竞争——这两样 ChatGPT 的内置麦克风并不打算提供。
第三条线——文档原生语音——将继续与聊天分岔。日历驱动的工作区把事件当触发器;填进事件文档的语音,与通用助手里的 GPT-Live 是不同的产品形态。随着 agent OS 产品成熟,注意观察语音输入是挂接持久工作区(第四代文档分支)还是临时会话(第四代聊天分支)。ChatGPT 目前领导后者;互补工具领导前者。
对实践者,可执行的预测很朴素:现在就把两个图标都学会,在内部手册里正确标注(「波形 = 说话;麦克风 = 用嘴打字」),agent 规格默认走听写。等 OpenAI 扩展 Live 的工具与插件支持时再回看 Voice Mode——Live 每多一项能力,「不得不落到文本」的场景就少一个,但高风险自动化里对可编辑提示词的需求不会被移除。
6. 结语
ChatGPT 语音模式 vs 听写最终归结为一个界面分岔、两个不同的提交点。由 GPT-Live 驱动的 Voice Mode(现代 ChatGPT 版本上)是为流畅对话、打断与用音频思考优化的双向语音对话。Dictation 是进 composer 的语音转文本,为精确、审阅、以及让 agent 与工具无须解读一段对话转写即可消费的提示词而优化。当实时听到并调整就是工作本身时,用 Voice Mode;当屏幕上那些字——按你批准的样子——就是工作本身时,用 Dictation。
两者互不替代,单独哪一个也覆盖不了必须活得比聊天线程久的文档原生语音工作流。对那条互补车道,Floatboat Flow Mode 这类工具的文档中心听写让语音留在你正在交付的文件里——当你的推理发生在聊天、而交付物活在一份挂接日历的文档中时,值得与 ChatGPT 搭配。先确定模态,再选图标;让 agent 执行走你掌控的文本。
https://floatboat.ai/zh/blog/chatgpt-voice-mode-vs-dictation