
Vibe Coding 很擅长回答一个问题:这个想法能不能做出来?可一旦问题变成“别人能否安全地修改、测试、部署并撤销它”,光靠顺手的对话就不够了。
两者之间缺的不是一条更厉害的提示词,而是一套能把意图变成证据的工作流。
**信息核对截至 2026 年 10 月 13 日。**具体工具的界面还会变,但本文讲的任务边界、可执行检查、Diff 审查和受保护合并,并不依赖某一个编程 Agent。
如果你还在厘清这个概念,可以先看 Vibe Coding 到底是什么。本文从原型需要变成长期维护的软件那一刻讲起。
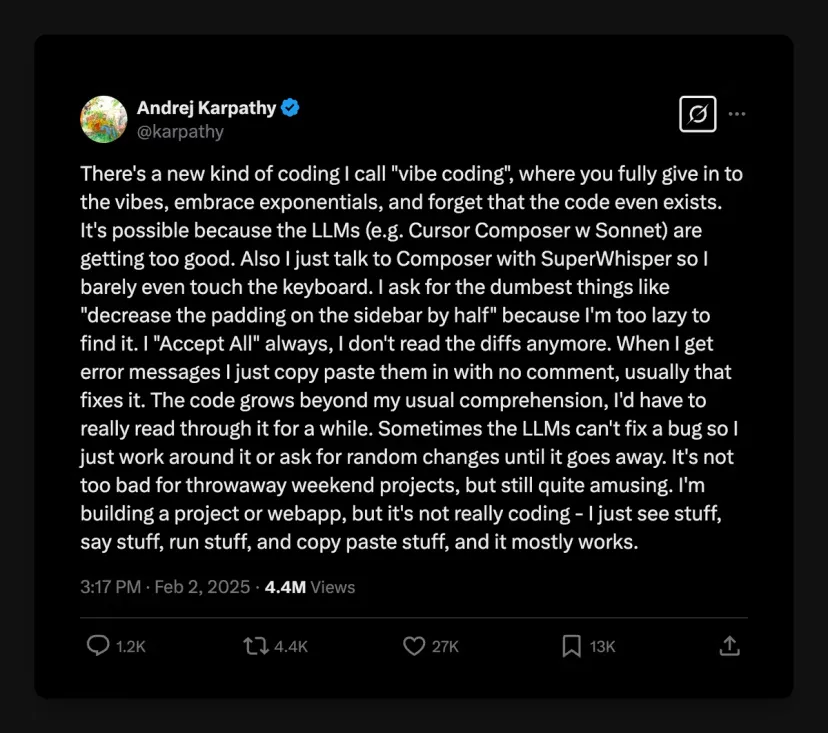
Vibe Coding 从哪一步开始不够用
风险不在“代码由 AI 生成”这件事本身,而在于:没有清晰的成功标准,也没有可靠的回归检测,就直接接受了代码。
一次性的界面草图,边聊边改通常就够了。出现下面任一情况,就该切换工作模式:
- 已经有真实用户或客户数据;
- 方案涉及登录、支付、权限、密钥或删除操作;
- 一次改动会跨越多个组件;
- 代码以后要交给别人维护;
- 出错后必须能够回滚;
- 这个功能要经得住下一次修改。
到了这条线之后,“看起来能用”就不再是验收标准。Agent 需要一个边界明确的任务,仓库也需要一套不靠 Agent 临场记忆的约束。
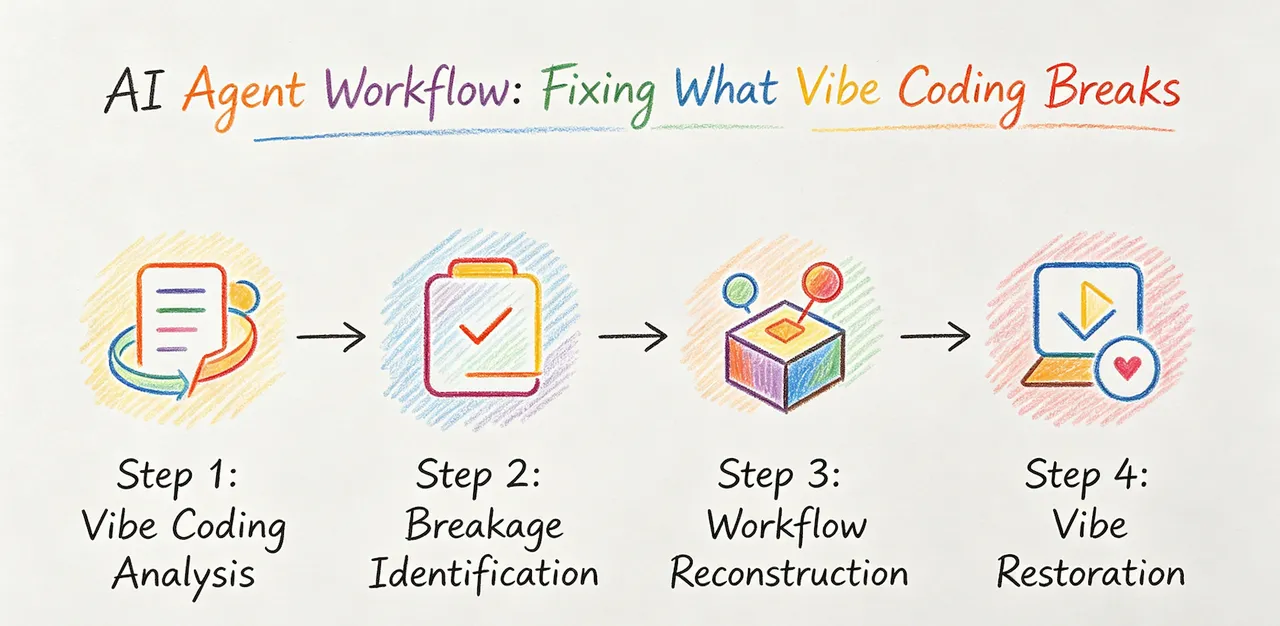
一套七段式 AI Agent 工作流
无论你用的是 IDE Agent、终端 Agent,还是后台执行的编程服务,都可以套用下面这套循环。关键不在工具,而在每一段之间交接什么。
1. 先写验收包
交给 Agent 的应该是一份短小的任务包,而不是一句愿望。至少写清:
- 用户最终会看到什么变化;
- 哪些事情明确不做;
- 正确与错误行为的例子;
- 可能涉及哪些文件或子系统;
- 必须通过哪些命令;
- 安全、隐私、性能与兼容性限制;
- 交付时要提供什么证据。
“加一个 CSV 导入”只是愿望。“接受 10 MB 以内的 UTF-8 CSV,遇到未知列就拒绝,解析失败时不得写入半成品,并通过这三份夹具”才是能执行、也能验收的任务。
2. 改代码前先画仓库地图
让 Agent 找出相关入口、数据流、既有测试和潜在副作用。它的回答未必全对,但能让错误假设在变成大段 Diff 之前暴露出来。
如果是一个陌生故障,复现也属于这一段。一个稳定失败的测试或最小复现,远比一句“上传坏了”更适合作为起点。
3. 审计划,然后冻结范围
计划里应列出预计修改的文件,并说明每个文件为什么要动。若一份计划悄悄把新功能、依赖升级、数据库迁移和顺手重构揉在一起,就应该退回重写。
范围不是永远不能变,但必须明着变。实现中发现新依赖时,先停下,更新计划和验收包,再继续。这样可以防止 Agent 为了保住当前思路,不断把任务越做越大。
4. 在分支里、以最小权限执行
只给 Agent 这次任务需要的仓库、凭据、网络和命令权限。使用功能分支或隔离工作树,让这次修改能与其他工作清楚分开。
最小权限不只是安全措施,也是质量措施。一个不能写出目标工作区、也不能直接部署到生产环境的 Agent,即使判断错了,造成事故的路径也少得多。
5. 跑确定性的检查
Agent 可以建议测试,但能不能通过,应由仓库现有规则决定。按项目需要运行格式化、Lint、类型检查、单元测试、集成测试、构建、迁移校验、密钥扫描等检查,并保留命令和结果。
测试不能替代审查,它只是可执行的验收证据。NIST 的 安全软件开发框架 把代码审查或分析、以及可执行代码测试列为不同的实践:两者都用来发现漏洞、验证要求。
6. 审 Diff,不要只读 Agent 总结
Agent 的总结只能当导航,真正要上线的是 Diff。
审查时重点找:
- 超出约定范围的修改;
- 被删掉的校验、鉴权、日志或错误处理;
- 新增依赖和生成文件;
- 数据结构变化能否撤销;
- 对外接口是否被悄悄改动;
- 测试是否只是在印证实现,而不是验证需求;
- 密钥、个人数据与遥测变化。
GitHub 对自家编程 Agent 的官方建议也是:合并前要 完整审查 Pull Request。这条原则适用于任何编程 Agent。
7. 通过门禁合并,并留下回滚路径
默认分支应该受保护。GitHub 可以在合并前强制要求批准审查、状态检查通过、对话已解决等条件;其 Pull Request 管理文档 说明了保护分支和 Ruleset 如何执行这些规则。
交接说明至少要包含行为变化、校验结果、已知限制、部署说明和回滚步骤。如果没人说得清怎么撤销这次修改,那么 CI 变绿也不等于可以发布。
把长期规则放进仓库
每次对话都重新解释架构和测试要求,很容易漏。稳定的规则应该和代码放在一起:构建命令、目录职责、命名方式、禁止操作、生成文件策略,以及怎样才算完成。
文件名取决于工具。以 GitHub 为例,它的 仓库指令文档 介绍了全仓库指令、按路径生效的指令,以及对 AGENTS.md 的支持。往外看一层,这就是 Agent Harness:围绕模型搭起指令、权限、工具、状态和校验。
指令要短,而且能执行。“写干净的代码”没有帮助;“运行 npm test 和 npm run typecheck,不要编辑 src/api/generated 下的生成文件,迁移必须提供回退路径”才有用。
这些说明本身也要维护。过期命令或旧架构描述,往往比没有说明更容易把 Agent 带偏。
三个不能交给 Agent 代替的检查点
例行校验可以自动化,但下面三个决定必须有人负责。
产品检查点
开始实现前,要由人确认验收标准描述的是正确行为。Agent 可以指出歧义,但当需求互相冲突时,它不能替你决定谁的需要优先。
风险检查点
登录、鉴权、支付、删除、加密、个人数据、基础设施、依赖变更和数据库迁移,都应该明确经过安全或领域审查。影响范围越大,任务就应拆得越小,批准规则也应越严格。
发布检查点
最终仍要有人判断证据是否足够上线。这里还包括代码测试之外的问题:监控、功能开关、数据回填、客服影响,以及回滚是否真能执行。
一个小例子:给账单应用加 CSV 导入
假设一名独立开发者让 Agent 给账单应用增加 CSV 导入。
Vibe Coding 版只有一句:“给发票加 CSV 导入。”结构化版本则是一串不长的步骤:
- 定义编码、列、大小上限、重复项策略、部分失败行为和权限检查。
- 找出既有上传入口、发票校验器、事务层、审计日志和测试。
- 审批一份只涉及导入接口、解析器、服务层和夹具的计划。
- 先覆盖正常文件、未知列、重复发票、未授权用户和行级失败后回滚。
- 在没有生产凭据的分支里实现。
- 运行测试、类型检查、依赖与密钥扫描,再检查完整 Diff。
- 必要检查全部通过后才合并;用功能开关发布,同时准备错误率告警和关闭路径。
这套流程并不拖沓,因为多数检查点都很小。它总比上线后才发现解析器失败前已经写入半批数据更快。
先设计流程,再挑工具
工具横评很快就会过时。先问四个更耐用的问题:
- Agent 能否先检查仓库、展示计划,再开始编辑?
- 你能否限制它的文件、网络、命令和凭据权限?
- 它能否运行仓库真正使用的检查,并返回原始结果?
- 它能否产出可审查的 Diff 或 Pull Request,同时不绕过合并规则?
需求还很模糊、需要频繁反馈时,交互式编辑器可能更合适;跨文件修改和本地校验,终端 Agent 往往更顺手;验收标准很清楚的有界任务,则适合后台 Agent。无论选哪一种,都不能省掉上面的七段流程。
保留速度,用证据替代侥幸
Vibe Coding 是很有价值的探索模式。真正的问题,是把探索阶段的验收标准直接带进了长期维护的软件。
可靠的 AI Agent 工作流并不假设模型永不犯错,而是让错误在代价还低时露出来:先定需求再改代码,先写仓库规则再临场发挥,先跑测试再谈信心,先审 Diff 再合并,先备好回滚再发布。
这套方法也不只适用于代码。调研、内容和文档流程同样会因明确的请求、允许使用的来源、校验项目、批准节点与最终证据而变得可靠。
相关文章
Gemini Agent 是什么?Google 通用工作 Agent 详解
Gemini Agent 是 Google 面向企业工作的通用 Agent,支持持久执行、多 Agent 协作、多模型路由和业务工具连接。本文解释它与 Gemini App 的区别、核心能力、开放状态及现阶段限制。
AI Agent Connector 详解:MCP、OAuth 与权限边界
从实际工作流解释 AI Agent Connector 如何组合 MCP、OAuth、Scope、资源权限与人工审批,并提供选型、试运行、故障定位和安全核查方法。
Agent Harness 是什么?从执行循环到安全恢复
系统解释 Agent Harness 的架构:执行循环如何连接上下文、工具、沙箱、权限审批、可观测性与失败恢复,以及如何区别模型、Framework、Connector 和 Workspace。
https://floatboat.ai/zh/blog/ai-agent-workflow-vibe-coding