
什么是持久化 AI Agent——以及它为什么重要?
嗨,我是 Nova。最近我一直在想这个概念,今天终于坐下来好好把它写出来。
我不断看到「Hermes Agent」出现在我的信息流里——开发者在聊它、GitHub 上有技术讨论帖、偶尔还有人在 Reddit 兴奋地晒自己在 $5 的 VPS 上跑它。我的第一反应是划过去:又一个 AI 工具,八成只面向开发者,八成跟我实际的工作方式无关。
但后来我撞见一句话,被它拦住了:「大多数 AI 工具是无状态的——每一段对话都从零开始。」
好吧。这句话扎到我了。因为这个问题我_每天_都在感受。
这篇文章不是 Hermes Agent 的搭建教程,而是我想把脑袋里这个概念理清楚——持久化 AI Agent——以及它对我们这些不是开发者的人到底有没有意义。
什么让一个 AI Agent「持久」——它和聊天机器人有什么区别
我可以用最简单的方式讲这个区别。
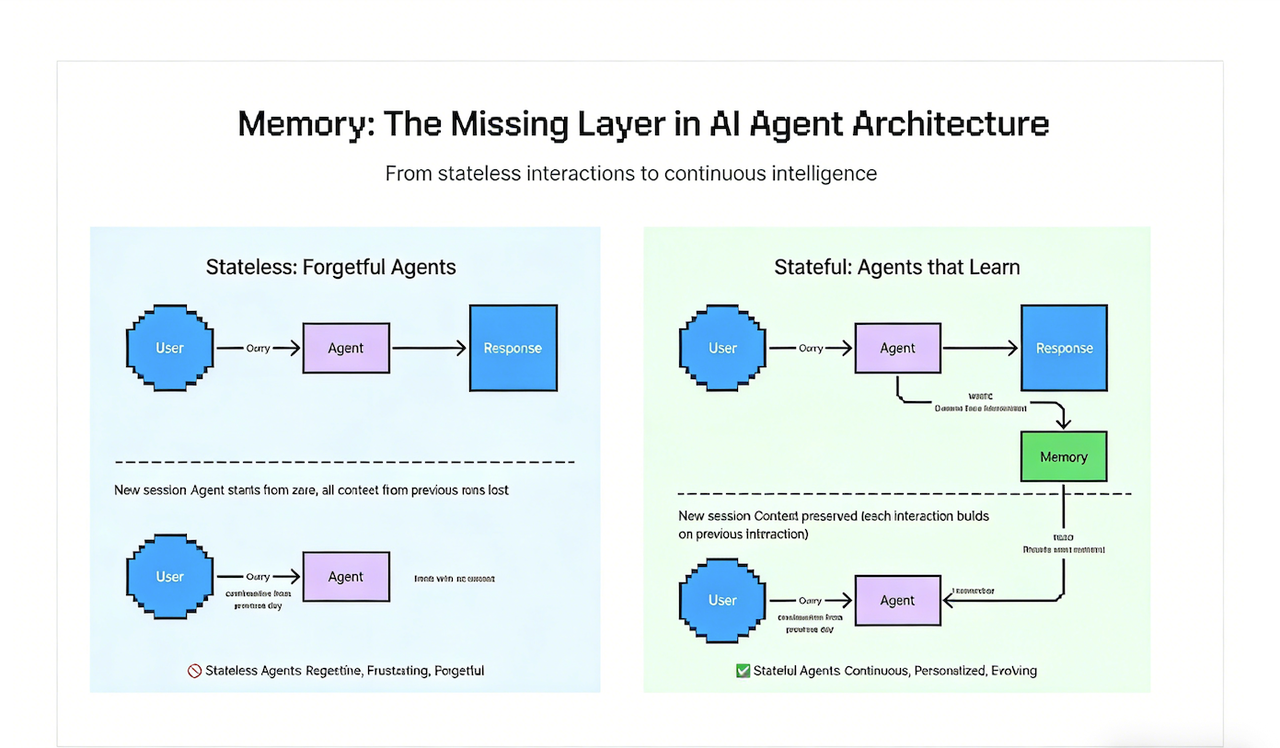
当你打开 ChatGPT、Claude 或任何标准聊天界面时,这个 AI 对你没有任何记忆。哪怕你昨天刚跟它聊过一场关于你的内容策略、客户偏好、你的小众利基的精彩对话——那一切都不存在了。你重新开始。每次都重新开始。
这就是「无状态」的意思。模型处理的是你现在、此刻、这个会话里给它的东西,然后石板被擦干净。
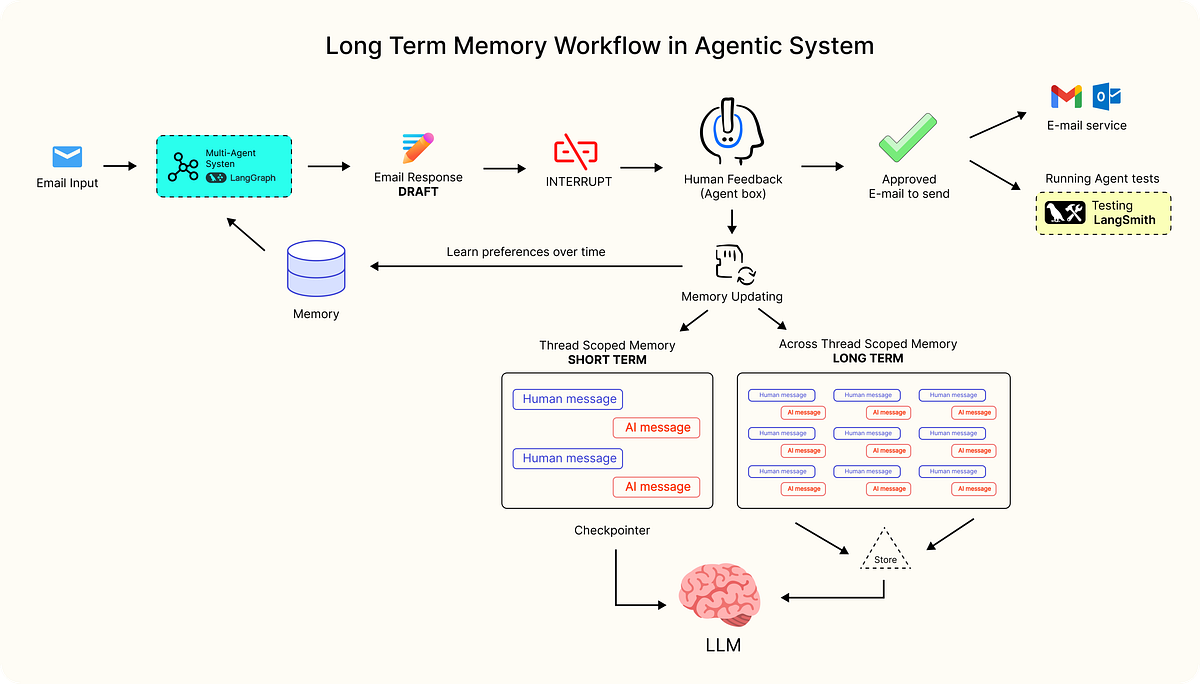
**持久化 AI Agent 恰恰相反。**它的设计目标是把信息带向未来——你的偏好、你的工作模式、它帮你解决的问题——横跨每一次会话、每一天。不只是你可以往回翻的聊天历史,而是一个关于「你是谁、你怎么工作」的、真实在演进中的模型。
LLM 的传统记忆像内存(RAM):对当前上下文访问快,但每个会话结束就被清空。AI 原生的记忆更像硬盘:信息被持续存储、更新和引用。这个区别听起来很技术,实际差别却巨大。
会话式 vs 持久化:真正变的是什么
回想一下你上次打开一个 AI 工具的新对话、花开头五分钟重新解释你的项目、你的语气、你的受众、你的约束——那不是在偷懒,你只是在做这个工具要求你做的事。
**持久上下文解决的正是这个摩擦。**Agent 记忆支持跨会话的长期回忆,维持上下文窗口无法保住的持久身份与习得行为。有状态的 Agent 能自动化无状态系统根本处理不了的工作流——它跨对话维持上下文、从过去的交互中学习、并基于历史模式做决策。
持久化 Agent 解决的「上下文重置」问题
有件事我给它起了个名字叫「重新交代税」——每次会话都要向 AI 重新解释自己,那种看不见的时间成本。单看一次会话不大,但会累积——尤其当你在做积累了大量上下文的长期项目时。
更深层的问题是:单纯扩大上下文窗口解决不了这个——真实负载下性能会下降、检索变贵、成本叠加。有研究者把这叫「上下文腐化(Context Rot)」:不做上下文管理的话,AI Agent 的回答可能变得不准确、不可靠。
持久化 Agent 换了个思路。它不是把一切倒进单一窗口,而是有选择地存储和检索真正重要的东西。
持久化 Agent 到底记住了什么
这部分是我觉得真正有意思的地方——不只是「它会记」,而是它_记住什么_、怎么记。
你的项目、偏好与工作模式
按 AWS 官方文档对 Agent 记忆的表述,目标是让一次性的对话变成持续的、演进中的关系——Agent 不再反复问同样的信息(「您的账号是多少?」),而是记住真正要紧的偏好(「我对贝类过敏」)。
把这套用到知识工作上:一个知道你写作风格、喜欢早晨同步、手上有三个受众各不相同的进行中项目的 Agent——那是一种不一样的协作关系。
从解决难题中练出的技能
这里是 Hermes Agent 具体做了一件我以前没见过的事:完成一项复杂任务后,Agent 会把方法保存成下次可复用的「技能」。这些技能以结构化文档存储——Agent 在困难任务后自动创建它们,并采用渐进式披露(Progressive Disclosure)模式,把不必要的 token 消耗压到最低。
我想到的最贴切的类比是:它不像你随手拿起的工具,更像一个边摸索边给自己写 SOP 的初级助理。
它可以搜索和召回的历史对话
与每次独立处理任务的传统 AI 模型不同,带记忆的 AI Agent 能保留上下文、随时间识别模式、并根据过去的交互调整自己——这些能力对需要自适应学习的、以目标为导向的应用至关重要。
能问出「上个月关于这件事我们定了什么」并真的拿到有用答案——这是我反复回到的用例。
Hermes Agent 这类项目想做什么
Hermes Agent 是 Nous Research 做的开源项目,2026 年初发布。我自己没搭过——这点我直说——但我把官方文档读得挺仔细,这套架构即使你永远不运行它也值得理解。
核心理念:一个越用越强的 Agent
Hermes Agent 的出发点,正是「大多数 AI 工具是无状态的——每段对话都从零开始」。它给出的替代方案是:一个持续积累知识、构建技能、用得越久越有用的 Agent——带横跨所有会话的持久记忆,让你不必重复自己。
吸引我注意的是:这个学习循环是明确写进架构里的,不是外挂功能。Agent 被设计成会主动提示自己存储知识、搜索自己的历史对话、并随时间构建关于你的模型。
为什么这不同于 ChatGPT Memory 或 Notion AI
两个我都用过。ChatGPT 的记忆功能有用但浅——它存离散的事实(「用户偏好要点式列表」),抓不住你工作的质感。Notion AI 只在你已经放进 Notion 的内容里运作——它不观察你的行为、不形成自己的理解。
Hermes Agent 这类项目的架构野心,比给会话式工具外挂增量记忆功能走得更远:它们从地基起就为持续运行、随时间学习、跨消息平台触达用户而设计。
那是另一个类别的存在。而「这个类别是不是我们大多数现在就需要」——才是那个诚实的问题。
谁最受益于持久化 AI Agent
以下是我的真实看法,我不绕弯子。
如果你是开发者或研究者——会管基础设施、在终端里工作、熟悉 SSH、Docker 和命令行配置的人——Hermes Agent 这类持久化 Agent 现在大概真的会让你兴奋。这套系统支持六种终端后端(local、Docker、SSH、Daytona、Singularity 和 Modal),有无服务器持久化选项(空闲时环境休眠),还能从单一网关对接多平台消息。如果你知道拿它做什么,这确实是一套强大的配置。
如果你是单人创业者、内容创作者或知识工作者、不碰基础设施——这个概念本身跟你有关系,但当前大多数持久化 Agent 的实现,还不是为你做的。
搭建开销是实打实的。你得习惯在某台服务器上跑东西、管理配置、并容忍早期开源项目特有的那些毛糙边缘。
持久上下文这个_理念_——一个真正懂你工作的 AI——对我们怎么工作至关重要。而以非开发者能接受的方式交付它的工具,还在追赶。
「持久化」解决不了什么
这点我要说得清清楚楚,因为我看到这个概念周围有太多吹嘘,却不够诚实的核算。
**搭建开销很大。**让 Agent 持久运行需要基础设施。对我认识的大多数单干圈的人来说,这是真实的门槛——不是立场问题,纯粹是时间和注意力的现实问题。
**维护是件真事。**一个持续学习、构建技能的持久化 Agent,需要一定量的打理。过时的记忆、无关的技能、相互冲突的上下文——实践里,记忆常常是碎片化、持续存在又隐形的。Agent 可能带着你的个人信息运转,却不把它们展示给你——这就产生了便利性与隐私、问责风险之间的权衡。
**信任与自主的边界。**给 Agent 一份关于你怎么工作的持久知识,确实有用。但它自主运作得越多,你就越需要理解它在做什么、为什么。这项能力,我们大多数人还没练出来。
这个概念会走向哪里——以及该盯住什么
诚实的回答是:我们还很早。「持久化 AI Agent」这个品类是真的,它解决的底层问题也是真的。但以非开发者能接受的方式解决它的工具,才刚刚开始出现。
我会盯住的是:工作区层。把「持久上下文」这个理念、用不需要搭服务器的界面交付出来的工具。比如 Floatboat 就在从工作区这一侧切入——通过桌面应用学习你的实际工作方式,而不是自托管一套 Agent 运行时。这是通往同一个底层想法的不同入口:一个随时间了解你的 AI。我用它还不够久,给不出强意见,但我会留意这个方向。
更大的规律是:随着 AI 系统在各类工具、应用和环境之间自主运作,持久记忆让这些系统能够推理、反思并持续行动——从无状态的执行者,进化为自适应协作者。
这个转变一定会来,无论某个具体工具会不会成为大多数人接触它的方式。
我还在摸索——持久化 Agent 这块跑得太快,我这会儿写下的任何东西,几个月后可能都会显得不完整。但我认为底层的概念已经清晰到值得跟踪:区别在于「一个在会话里帮你的 AI」和「一个真的懂你怎么工作的 AI」。
这个转变很重要。至于谁会用真正平易近人的方式交付它——那是接下来我要盯的事。
总之,这是今天的发现。或者至少是今天一次诚实的尝试——把一件我真心觉得有意思的东西画成地图。
往期文章
常见问题
持久化 Agent 和普通聊天工具有什么区别?
持久化 Agent 到底能记住什么?
它跟 ChatGPT 记忆或 Notion AI 有何不同?
现在用持久化 AI Agent,必须会写代码吗?
Agent 记错关于我的信息,有什么风险?
想先体验持久上下文,最轻量的方式是什么?
https://floatboat.ai/zh/blog/what-is-persistent-ai-agent