
MiniMax H3 Max 直播演示:生成速度比播放还快
把 MiniMax H3 Max Live 作为实验性连续视频管线评估,覆盖官方状态、价格、吞吐、缓冲、审核与成本测试,核验于 2026 年 10 月 13 日。
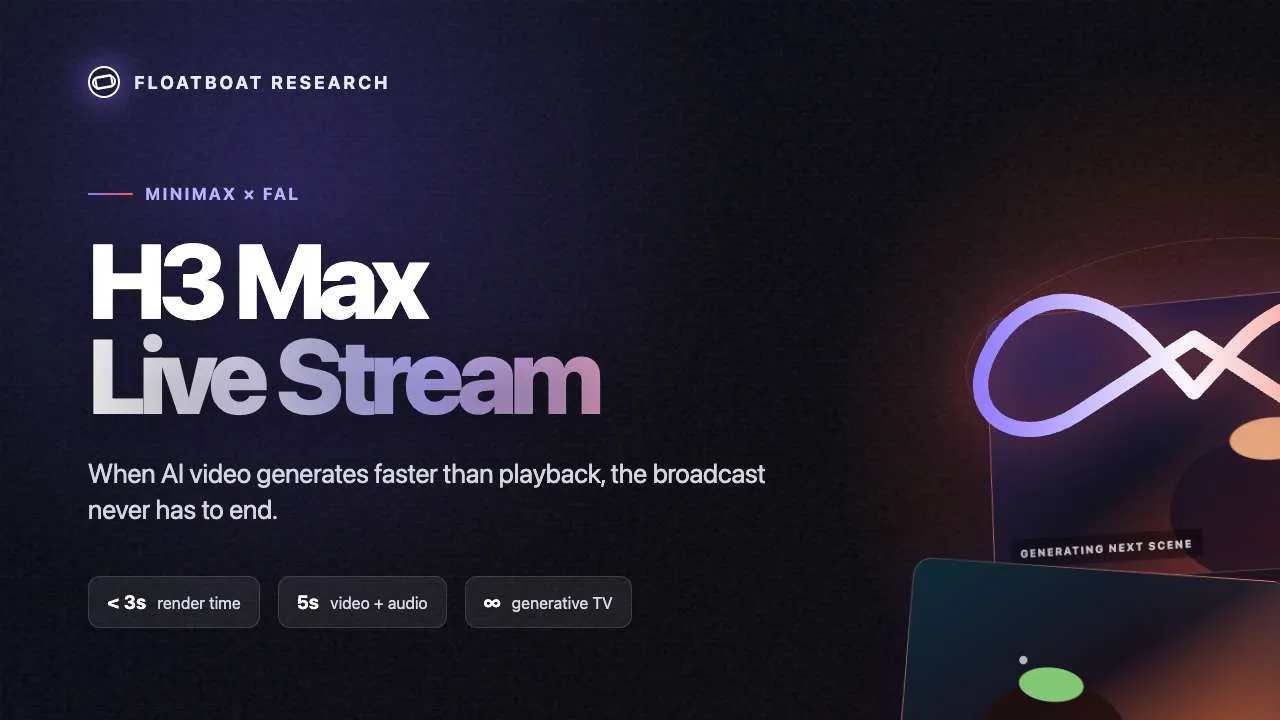
“无限 AI 直播”并不是一次生成一条无限长视频,而是一套不断生成短片、缓冲、无缝拼接、推流并能安全停机的生产系统。评估 H3 Max Live,应看整条媒体管线,而不是套用文本模型的榜单方法。
官方说法与公开状态核验于 2026 年 10 月 13 日。 fal 的 H3 Max 公告展示了 H3 Max 与实验性 Live 演示;在围绕它设计系统前,必须确认当前端点是否实际开放。
连续直播背后的六段循环
最小架构至少包括:
- 场景规划器把故事状态与观众输入变成下一段受约束提示词。
- 多个生成 worker 并行请求短视频片段。
- 校验器剔除不安全、损坏、无声或连续性差的片段。
- 缓冲区始终保留若干已通过片段。
- 合成器统一帧率、响度和转场。
- RTMP 或 HLS 推流,控制面负责暂停、兜底与紧急停止。
即使 5 秒片段只需 3 秒生成,队列波动、重试、审核、编码与上传也可能把缓冲耗尽。
官方演示能证明什么,不能证明什么
fal 报告称,H3 Max 可在 3 秒内生成一段带同步音频的 5 秒 768p 视频,并称速度约为 MiniMax 官方 H3 端点的 35 倍。这是厂商在特定演示条件下的结果,不是对所有提示词、地区、分辨率与并发的吞吐保证。
当前时长、分辨率、音频、输入字段和价格应以 fal H3 Max 模型页为准。实验性 Live 界面也不能直接理解为公开、带 SLA 的流媒体 API。
先算缓冲,再谈创意
定义 R = 生成出的媒体秒数 / 墙钟秒数。持续直播要求扣除失败后的长期 R > 1。更稳妥的门槛是较低分位吞吐仍大于 1,并以完整片段数设置缓冲下限。
至少用三类提示词压测:简单说话场景、高运动场景、参考图连续性场景;分别在 1、2、4、8 个 worker 下记录 p50/p95 生成时间、拒收率、音频失败、转场缺陷与缓冲深度。测试应持续数小时,十分钟演示看不出内存泄漏与队列漂移。
内容审核与真正的 kill switch
观众输入在进入规划器前审核,生成结果在进入可播放缓冲前审核。审计日志应保留提示词、模型版本、可用时的 seed、审核决定与已发布片段 ID。
紧急开关必须同时停止新生成、拦截排队片段、让编码器切到预先批准的兜底素材,并在必要时撤销推流凭据。只停止提示词循环的按钮不够。浏览器 Agent 安全问题提供了最小权限思路;MiniMax H3 是什么介绍底层模型家族。
24/7 成本要把废片和播出链路算进去
全天直播包含 86,400 秒成片。如果按生成秒计费,基础项是 86,400 × 当前单价,再乘生成冗余并除以验收通过率;之后还要加规划模型 token、参考素材、内容审核、编码 GPU、存储、流量、监控与运维值守。
可复用的公式是:
日成本 = 86,400 × 视频单价 × 副本数 / 通过率 + 规划 + 审核 + 编码 + 分发 + 人力。
仅 10% 拒收率,就需要生成超过 96,000 秒素材,尚未计入冗余。促销价不能作为长期商业模型。
上线与否的硬门槛
只有数小时压测始终守住缓冲下限、音频与转场达到验收标准、紧急停止在高负载下有效,且按当前公开价格计算仍可承受,才适合继续。否则应采用定时预生成节目块或插入审核过的兜底片,不能把脆弱演示包装成“7×24 小时直播”。
相关文章
GPT-6.1 Sol 详解:价格、性能、开放范围与模型对比
GPT-6.1 Sol 以 Astra 五分之一的标准 token 价格,提供接近 Astra 的编程、电脑操作与专业工作能力。本文解释这些数字真正意味着什么。
Jev 是什么——不生成文本的决策模型
Jev 是 TypeSafe AI 发布的 System One 模型:读取状态、返回带置信度的 typed decisions,而不生成任何文本。本文拆解其 RLCD 训练方法、官方宣称的 193.6x 加速与 444.6x 成本优势,以及 Hacker News…
DeepSeek V4.1 Flash:正式版状态、规格、价格与迁移
DeepSeek V4.1 Flash 已成为正式 Flash 模型。本文核对生产模型名、1M 上下文、视觉能力、峰谷价格、退役别名、V4 Pro 临时路由,以及从限时测试版迁移时必须复测的关键项目。
https://floatboat.ai/zh/blog/minimax-h3-max-infinite-ai-livestream