
LLM 知识库可以让分散资料更容易检索,但也会新增一套需要治理的系统。对单人经营者,真正的问题不是“能不能搭”,而是“检索节省的时间,是否大于导入、复核和清理所花的时间”。
信息核对截至 2026 年 10 月 13 日。
LLM 知识库到底做什么
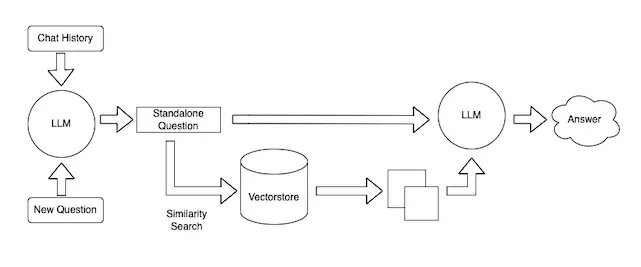
它的核心是检索:先给文档建立索引,再针对问题选出相关片段,最后让模型基于这些片段回答。OpenAI 的检索与文件搜索文档描述了同一类基本机制。自动生成的 Wiki 还会增加摘要和互链,但这些仍是模型产物,并不会自动变成已核实事实。
因此,知识库可以帮助你在提案、访谈、制度和研究笔记之间找回信息,却不能保证资料仍然最新、抽取结论一定正确,或答案覆盖了全部例外。LLM Wiki更适合作为原始资料之上的导航层,而不是原始资料的替代品。
什么情况下值得搭
当同一批资料会反复使用、手工搜索已经明显拖慢工作,而且答案能用引用回到原文核验时,知识库才比较有价值。例如复用客户要求、跨项目查找决策,或从稳定的研究档案中定位证据。
如果资料每天剧烈变化、文档少到手工搜索更快,或者目标只是完成一次性交付,永久索引反而可能增加负担。此时临时项目文件夹或能连接资料源的 AI 工作区通常更省事。
演示里不显眼的成本
**导入质量:**扫描 PDF、表格、重复导出和缺失元数据,会在模型回答前就破坏检索质量。
**时效性:**系统必须有替换、删除和冲突处理规则。若不保存日期与来源权威级别,“最新版”没有可操作含义。
**权限:**客户资料不能被无关项目检索到。权限要覆盖索引与检索过程,而不只是界面。
**评测:**测试应覆盖精确查找、跨文档综合、来源冲突、证据缺失与拒答。没有原文支撑的流畅答案仍然是失败。
**维护:**连接器和转换链路都会出错。失败导入、过期资料与敏感数据保留,最终仍要有人负责。
自建、购买还是跳过
只有在需要特殊资料处理、严格部署控制,或成品工具无法满足检索逻辑时,才值得自建。若常见文件与应用连接已经够用,应优先选择托管工作区,把时间花在评估答案而不是运维基础设施上。任务是一次性的,或资料变化过快时,则应直接跳过永久知识库。
可以先用一个小语料集回答五个真实问题:强制显示来源,记录漏检,并比较节省与准备资料所花的时间。若小规模试验都无法稳定指回正确证据,加入更多文档通常只会放大问题。
原文视觉资料
以下图片恢复自文章最初发布版本,用于补充界面、流程或对比语境。涉及产品界面、价格、基准结果和模型可用性的画面属于历史记录;做当前决策前,请以厂商最新官方信息为准。
最低治理清单
- 明确资料负责人和更新频率。
- 每条生成答案都能回到原始文档。
- 区分权威记录、评论与草稿。
- 规定证据缺失或冲突时系统应该怎么做。
- 加入客户资料前,检查访问、删除与导出机制。
- 更换模型、分块方式或连接器后,重跑固定评测集。
对多数单人经营者,真正有用的版本往往比想象中小:一套高价值资料、清晰引用,以及稳定复核习惯。目标不是制造“第二大脑”,而是缩短从问题到可检查证据的距离。
相关文章
Markdown 简历——维护一份源文件,按需导出每种格式
把简历收进一个 Markdown 源文件,按需导出打印级 PDF、Word 和网页,招聘季不再从头排版。本文讲清简历的 Markdown 文件结构与 YAML 头写法、git 版本管理、三条导出路径的取舍,以及 ATS 机器解析到底读得到什么、又不能承诺什么。
Markdown 笔记工作流——比任何应用都活得久的记笔记方式
一套基于纯文本 .md 文件的笔记工作流:文件命名、标题分层、双链与 AI 辅助整理。为什么纯文本笔记比任何应用绑定都长寿,以及一个下午就能搭好的最小配置与长期维护习惯。
Obsidian Vault 是什么?文件、设置与边界讲清楚
Obsidian Vault 是设备上的本地文件夹,里面包含 Markdown 笔记、附件和该 Vault 专属的设置。本文讲清它实际存了什么、本地存储不等于什么,以及何时该拆分多个 Vault。
https://floatboat.ai/zh/blog/llm-knowledge-base-solo-operators