
2026 年最好的 AI Agent 平台
2026 年怎么选 AI Agent 平台(AI Agent Platform)?取决于你要构建的东西、谁来做后期维护,以及你需要的可控性、集成、监督与可迁移性。本文提供一套选型决策框架,而不是一份很快就会过时的排名。
又见面了,我是 Nova。每隔几周就有人问我一个相似的问题:"我该用哪个 AI Agent 平台?"
而诚实的答案是:取决于你真正想构建什么——以及你是否已经需要一个平台。
这个领域我探索了一阵子,测试不同工具,观察哪些留了下来、哪些被悄悄弃用。我反复注意到一件事:平台决策总是做得太早,且标准选错了。有人因为一个 demo 就选型,有人因为某个工具列的集成最多,有人因为论坛里有人说它最好。然后半年后,他们被锁进一个不合适的方案里,或者要从头重建。
所以这不是一份市面上所有 AI Agent 平台的排名——那份清单在我写完之前就会过时,而且也没多大用处。下面要讲的,是我在选型中打磨出的一套决策框架,以及那些经得起时间考验的评估标准。
平台决策框架
在评估任何东西之前,我先问自己三个问题:
-
这个 Agent 需要完成的具体工作是什么? 不是"自动化我的生意",而是具体的事——处理进站线索、总结研究资料、起草客户更新。含糊的目标产生含糊的 Agent。
-
做完之后谁来维护? 如果答案是"我自己,而且没有技术支持可依靠",那你能实际运行的东西就不同了。配置要求重、集成脆弱的平台,一个人维护起来代价很高。
-
如果我需要换平台怎么办? 这个问题总被无视。数据可迁移与逻辑可迁移是两回事。 你也许能导出数据,却导不出工作流逻辑。在某个平台上构建任何重要东西之前,值得先搞清楚这点。
这三个问题,能在你在免费试用上花掉哪怕一小时之前,就排除掉数量惊人的选项。
四类平台原型
"最好的 AI Agent 平台"这个问题很难孤立地回答,因为这一品类里其实装着四种截然不同的工具。把它们都叫"AI Agent 平台",有点像把电子表格和数据库当成一回事。
搭建型平台(Builder Platforms)
这类工具主要为构建 Agent 而设计——拖拽式可视化搭建器、提示词配置界面、预制模板。这一类的例子有 Relevance AI、Gumloop,以及 n8n 这类叠了 AI Agent 节点的工具。
最适合: 想不写代码就快速做出原型、且 Agent 不需要对接高度定制内部系统的人。代价通常出在深度上——你建得快,但复杂的分支逻辑会变得很别扭。比如 Relevance AI 允许你用自然语言描述 Agent 的用途,并推荐匹配的积木块。这对起步确实有用。我查过它的文档与定价档位——免费档对实验来说够用,付费档按 Agent 运行次数计费。
部署平台(Deployment Platforms)
这类平台的重心不是构建,而是让 Agent 在生产环境里可靠地跑起来——监控、日志、错误处理、扩展。LangSmith 在这里,面向已有云基础设施团队的 Amazon Bedrock、Google Vertex AI 这类云原生选项也在这里。
坦白讲,这类平台大多不是单人经营者该起步的地方。如果你是一个人,Agent 挂了你要能快速修好——而不是去调试一条分布式追踪链路。但知道这个品类存在很重要,因为有些"搭建"工具宣传的部署功能,其实只是托管运行,并不是生产级监控。
加了 AI 层的自动化平台
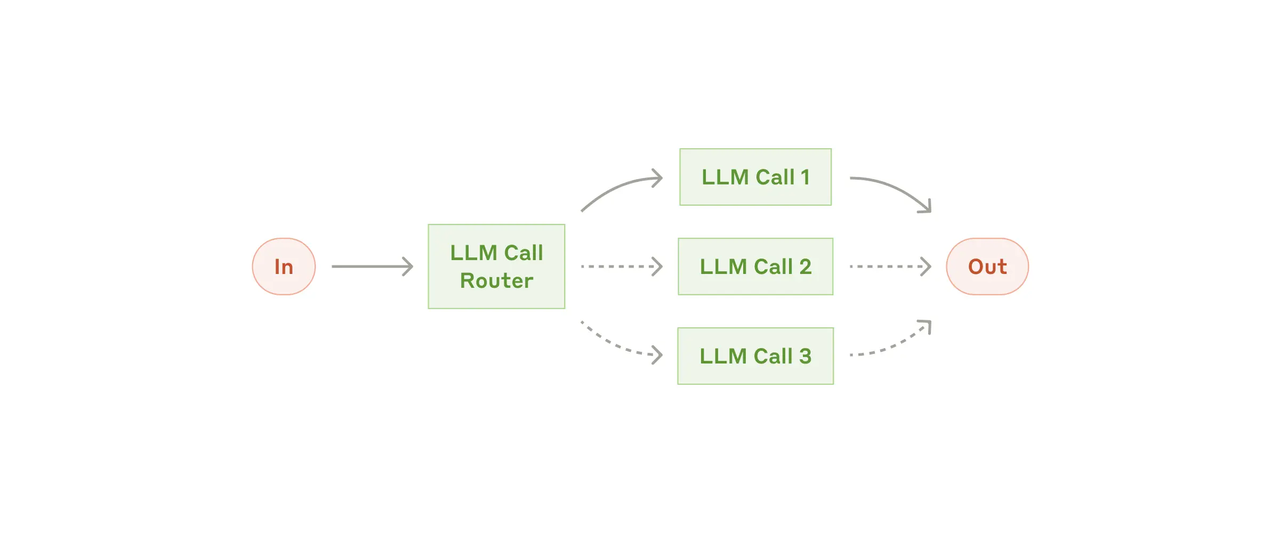
Zapier、Make、n8n 都从纯自动化工具起家,后来补上了 AI Agent 能力。这些值得理解,因为如果你已经在用其中某一个,你可能根本不需要一个独立的 Agent 平台。 Zapier 或 n8n 里的 AI 节点能处理数量惊人的类 Agent 行为——给输入分类、做决定、路由到不同输出。
局限通常出在上下文和记忆上。多数自动化平台是无状态的:每次运行都从零开始。如果你的 Agent 需要记得"上周二和某个客户之间发生了什么",就需要额外的架构——一个 Agent 可以读取的连接数据库或文档库。不是做不到,但多了几个会动的零件。
工作区(Workspaces)
这是一个被低估的品类。Claude.ai(带 Projects)、带自定义 GPT 的 ChatGPT、Notion AI——它们传统上不叫"Agent 平台",但对很大比例的真正用例来说,它们发挥的就是平台的作用。你给模型上下文、人设和某些信息的访问权,它就在那个上下文范围内执行任务。
对单人经营者来说,一个配置良好的工作区,常常胜过专用平台上建到一半的 Agent。 维护成本更低、更容易迭代、也没有可断掉的集成点。代价是:工作区通常不擅长自动触发,也不擅长在外部系统里采取行动——除非再搭一些管道。
单人经营者的评估矩阵
我在为自己的使用评估任何 AI Agent 开发平台、或给处境相似的人做推荐时,会按顺序看五件事。
可控性(Control)
我能看清 Agent 每一步在做什么吗?我能轻易覆盖或暂停它吗?一个你看不见内部的 Agent,是一个你无法信任的 Agent。 当 Agent 做的事有后果时——发消息、更新记录、做决定——这一点尤其重要。
有些平台给你执行日志,有些给你仪表盘,有些几乎什么都不给。在向某个平台交心之前,试着故意把你的原型弄坏——喂它错误输入,看看会发生什么。
上下文(Context)
Agent 如何跨任务持有和使用信息?无状态 Agent 应付孤立任务没问题。但凡是涉及持续工作的场景——客户关系、多天项目、知识积累——你都必须确切理解上下文是怎么存储、怎么取回的。
Anthropic 关于构建高效 Agent 的研究值得一读。它的核心观点是:复杂度只应该在"能明显改善结果"时添加。更多的上下文处理 = 更多复杂度 = 更多可能出错的地方。
集成(Integrations)
不是"这个平台有多少集成"——那个数字通常注水。真正的问题是:它能不能可靠地连上你的工作流真正依赖的那两三个具体工具?
我见过列了 500 多个集成的平台,而我需要的三个(某个特定 CRM、一个排程工具、Google Drive)全都有缺口或需要绕路。去查你需要的那些具体连接器,而不是总数。
监督(Oversight)
与可控性相关,但更微妙。平台是否便于在 Agent 采取某些行动前要求人工审批?凡是碰到对外沟通或真实数据的动作,我都希望工作流里有一个"先让我过目再发出去"的步骤。
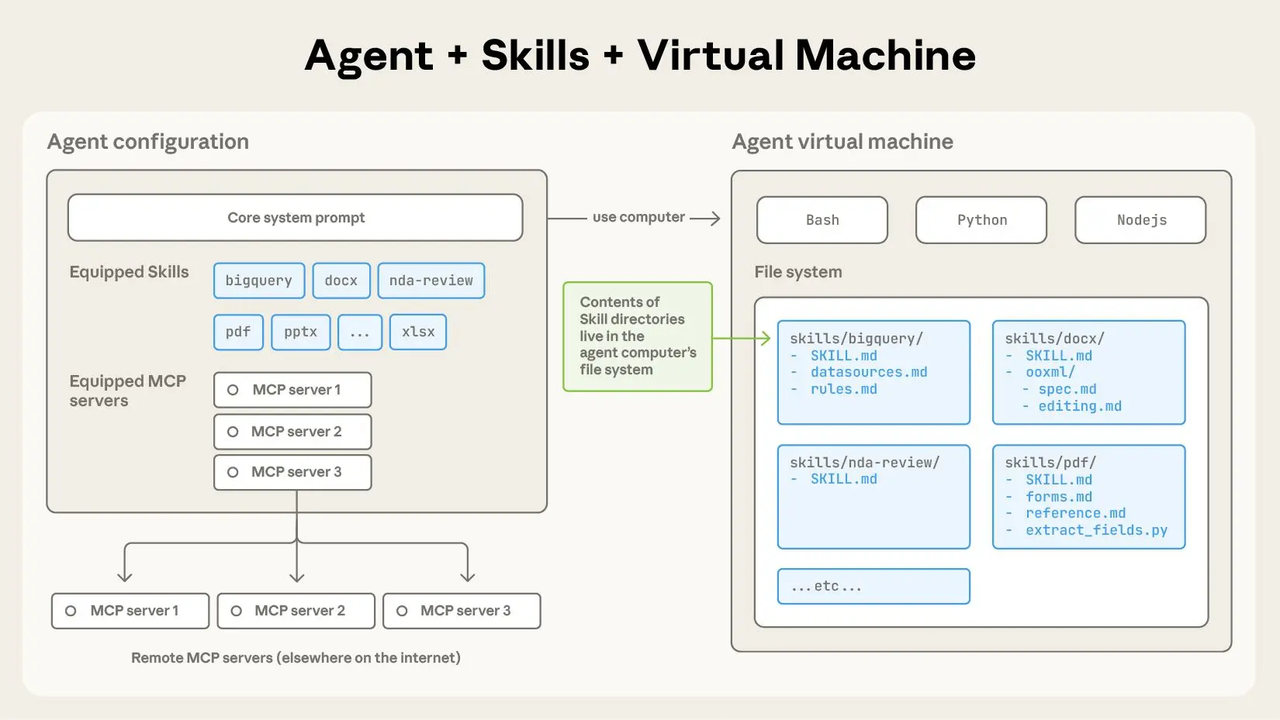
Anthropic 在 2025 年底发布了一个关于 Agent Skills 跨平台可移植性的开放标准——这也关系到监督层如何模块化设计,而不是焊死在某一个专有系统里。如果你想构建能长久存续的东西,值得一读。
可迁移性(Portability)
离开要付出什么代价?如果你的 Agent 逻辑整个活在某个没有导出格式的专有可视化搭建器里,换平台就等于从头重建;如果你的逻辑是用存在文本文件或简单配置里的提示词表达的,迁移会容易得多。
我现在把这条当成近乎一票否决的标准。 一个不能清楚告诉我如何导出工作流逻辑的平台,我不会在它上面构建任何重要的东西。
平台还是工作区:哪个先来?
在评估任何 AI Agent 搭建平台之前,我真正会先问的问题是:我真的需要一个平台吗?还是需要一个配置得更好的工作区?
工作区——Claude Projects、自定义 GPT、一套 Notion AI 配置——能承接很大一部分人们想要专用 Agent 平台去做的事。区别在于:工作区不会自动触发,不在外部系统里采取行动,除非额外搭管道。
我的实用法则:先从工作区开始,一直用到你撞上一堵具体的墙。 那堵墙通常是:"我需要它在我没打开它的时候运行"或"我需要它更新某个外部系统"。撞上之后,你就确切知道平台要补的缺口是什么了——这让整个评估聚焦得多。你不是在一百个功能之间比来比去,你只问一件事:某一个具体能力在你的技术栈里能不能可靠地工作。
n8n 关于 AI Agent 工作流的文档,对理解"自动化平台的终点"和"真正 Agent 行为的起点"很有帮助——尤其当你想搞清楚你的用例到底站在那条线的哪一边。
做决定前,先跑一个小规模试点
无论你在考虑哪个平台,都不要在沙盒模式里用干净、理想的测试数据去评估它。用一个真实用例、真实(哪怕低风险)的数据跑一个小试点。
具体做法:挑一件你每周至少做三次的重复任务。把 Agent 搭起来,让它跑两周,量三件事:准确率(输出和你手动做出来的匹配吗?)、可靠性(它是不是稳定运行、不宕不坏?)、维护时间(你被迫介入或修东西花了多少时间?)。
如果准确率 80% 以上、可靠性稳定、每周维护低于 30 分钟——那大概值得留下。如果三样里有一样不达标,它会告诉你问题出在平台、Agent 设计、还是任务本身。
Gartner 关于低代码采用的研究预计,超过 70% 的新企业应用将使用低代码或无代码技术——AI Agent 搭建器正是这股浪潮里增长最快的细分之一。但采用率不会告诉你哪个平台适合你的处境。那仍然要靠拿真实工作流去测试。
我到现在还在积极测试不同的选项。老实说,这个领域跑得太快,我对具体平台说的一切,可能几个月内就过时。我更确信的是那套框架——无论当下哪个工具正火,那五个评估维度都站得住。
如果今天我面临这个选择,我会从那里出发。
系列前文
-
Agent 新手?从这里开始:为什么多数单人经营者该先跑简单工作流、再建复杂系统 → 单人创始人的 AI 工作流
-
还在提示词、自动化和完整工作区之间犹豫?这篇把取舍讲得很清楚 → 工作区 Agent vs 工作流搭建器
-
做 Agent 最大的错误是太早自动化太多——这篇讲单人经营者如何真正规模化 AI 工作流 → AI Agent 工作流与 Vibe Coding
-
选工具之前,先理解"AI Agent"在实践中到底是什么——以及它们会在哪里悄悄失灵 → 给单人经营者讲清楚 AI Agent 工具
-
如果你的工作流已经横跨浏览器标签页、文档和本地文件,这篇深入讲为什么工作区 Agent 正在成为下一层 → 单人经营者的 AI 工作区 Agent
常见问题
2026 年真的存在"最好"的 AI Agent 平台吗?
Agent 平台和自动化工具不同吗?
我该从工作区开始,还是直接用专用平台?
对比平台时到底该看什么?
以后能换平台吗?
决定前该怎么测试一个平台?
https://floatboat.ai/zh/blog/best-ai-agent-platform-2026