
Meta Muse Spark 已经不是 2026 年 4 月发布时的那一个版本。截至 2026 年 10 月 13 日,Meta 把 Muse Spark 1.3 列为面向长程 Agent、编码和原生多模态感知的当前型号。因此,“Muse Spark 和某个前沿模型谁的分数更高”已经不是最有用的问题。一人公司真正需要判断的是:当前接入方式、任务匹配度和迁移成本,能否改善真实业务流程。
本文依据 Meta 公开资料梳理,不虚构亲测。厂商自述与用户可验证的决策标准会分开呈现。
Muse Spark 现在是什么
Meta 在 2026 年 4 月 8 日发布初代 Muse Spark,将其描述为支持工具调用、视觉推理和多 Agent 协作的原生多模态推理模型。Meta 当时也明确承认,模型在长程 Agent 与编码工作流上仍有差距。最初入口是 meta.ai、Meta AI 应用和私有 API 预览。
产品随后快速迭代。7 月发布的 Muse Spark 1.1开放了 Meta Model API 公测,并宣称具备 100 万 Token 上下文。Meta 当前的模型页面则把 Muse Spark 1.3 描述为面向长程编码与 Agent 工作流,并支持图片、视频和文档的多模态感知。
这些都是 Meta 的产品表述,不能直接证明它在你的任务上优于现有模型。真正有决策意义的变化是:一人公司如今可以通过开发者入口做受控评估,而不必只把 Muse Spark 当作 Meta 产品内的消费级助手。
决策核心是工作流匹配,不是榜单名次
一人公司切换模型,改动的不只是回答质量,还可能包括提示词、工具 Schema、审核规则、计费、数据处理与失败恢复。只有当 Benchmark 对应你反复执行的任务时,它才有价值。
| 工作负载 | 该测试什么 | 什么结果足以支持切换 |
|---|---|---|
| 多模态输入 | PDF、截图、产品视频、混合证据 | 抽取错误更少,人工预处理更少 |
| 调研与综合 | 来源落地、冲突处理、引用 | 在同一来源包上有更高的通过率 |
| 编码或浏览器执行 | 工具选择、状态跟踪、恢复 | 无危险动作、少人工接管的完整 Run 更多 |
| 日常写作 | 语气、约束、编辑负担 | 每份审核通过稿的总成本更低 |
初代发布重点是多模态感知、健康推理与并行 Agent 的 Contemplating Mode;后续版本则逐步强调 Agent 编码和 Computer Use。版本定位本身在变化,因此 10 月做决策时,不应继续套用 4 月的对比表。
不要把 Muse 自动等同于 Llama
Llama 让 Meta 以开放权重模型闻名,但 Muse Spark 最初是托管产品:消费端可用,同时只向少量伙伴开放 API。Muse Spark 1.1 才把 Meta Model API 推向公测;Meta 目前还宣传直接接入和 OpenAI-Compatible 的开发路径。
这并不代表 Muse Spark 就是开放权重的 Llama 继任者。如果你的硬要求是本地部署、权重可得、离线运行或基础设施完全可控,应核对当前具体型号提供的许可证和制品。托管 Endpoint 与开放权重 Checkpoint 对安全、成本和服务连续性的要求完全不同。
一套可复现的切换测试
1. 选 12—20 个已完成任务
选择有已知合格答案的重复工作,例如有来源的简报、客户邮件草稿、文档抽取、小型代码修改或结构化内容计划。候选服务未通过安全审查前,不要放入密钥或受监管数据。
2. 固定任务契约
所有候选模型使用同一份来源、输出格式、工具权限、时限和停止条件。不要为了救某一方而在测试中途改写提示词。
3. 记录业务结果
记录通过的结果数、事实修正、格式错误、工具误用、运行时间、复核分钟数和总成本。对于 Agent 任务,还要记录未授权动作、恢复次数,以及模型是否知道何时应当请求帮助。
4. 单独计算迁移摩擦
估算迁移提示词、集成、评测、日志与降级规则所需的工作。5% 的质量提升未必值得一周迁移;如果新的多模态能力能直接删除一个人工交接,价值就可能很高。
5. 保留退路
先让候选模型负责一条窄路径。高后果或尚未覆盖的任务继续留在原模型,直到新路径积累足够证据。Effort 与响应速度分流指南说明了如何按任务路由,而不是强迫所有任务使用同一模型。
哪些情况值得试 Muse Spark
如果工作流同时包含文档或视觉输入与工具调用,确实需要长上下文,或者你希望用现有 OpenAI-Compatible Client 比较 Meta Model API,Muse Spark 值得进入候选名单。Meta 当前资料也把编码与多 Agent 协作放在核心位置。
如果现有流程已经达到质量目标,迁移会打断营收工作,本地或开放权重是硬要求,或者任务依赖 Muse Spark 无法复现的特定厂商工具,就不必为了追新而切换。
涉及浏览器高后果动作时,模型能力也只是决策的一部分。还应按浏览器 Agent 安全问题清单检查站点权限、凭据、提示注入、审批与审计能力。
切换前要问清的八件事
- 当前入口实际提供哪个 Muse Spark 版本;
- 功能是正式可用、公测还是受地区限制;
- 当前上下文、速率与价格限制;
- 上传文件和 Run Trace 是否保留、是否用于训练;
- 工作流依赖哪些工具、结构化输出和兼容特性;
- 模型更新如何版本化,能否固定或回滚;
- 工具调用部分成功时如何恢复;
- 哪些任务仍要留在现有模型。
原文视觉资料
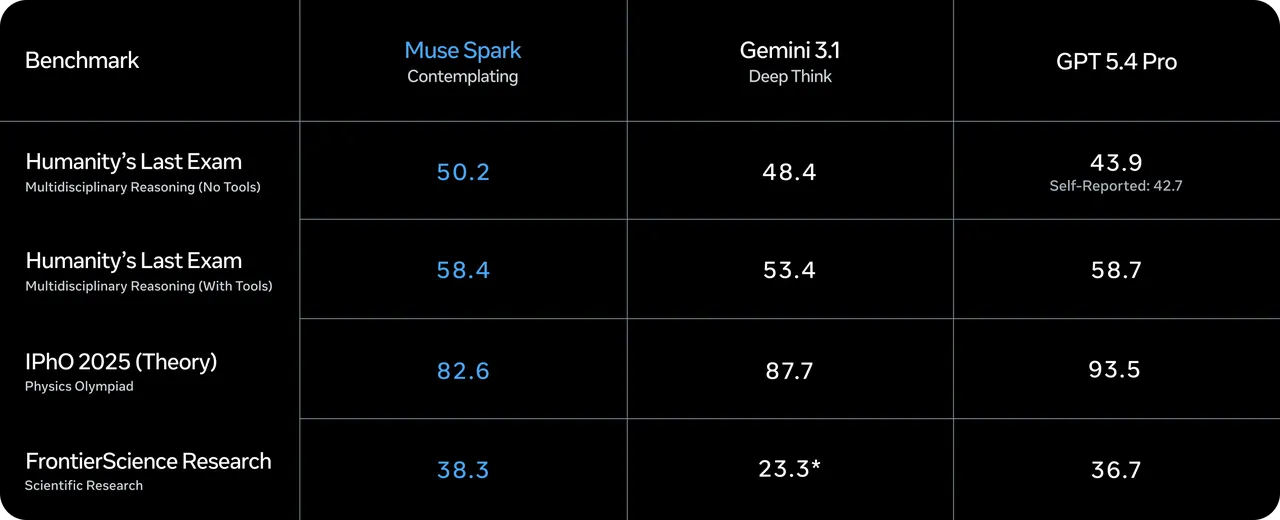
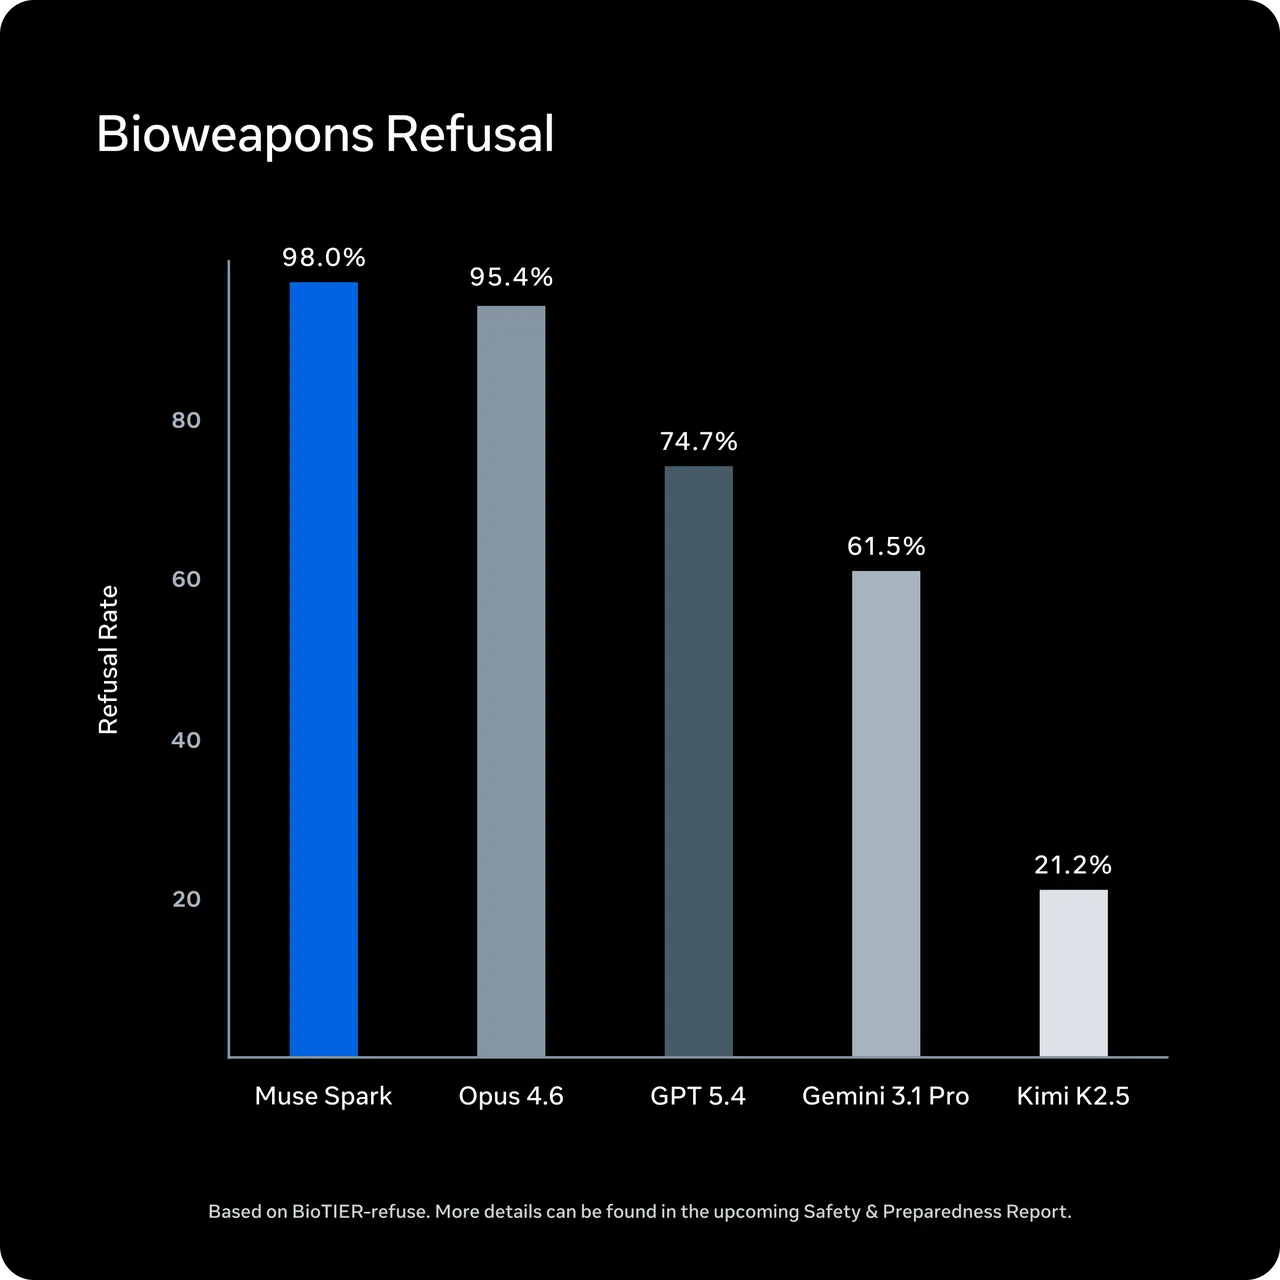
以下图片恢复自文章最初发布版本,用于补充界面、流程或对比语境。涉及产品界面、价格、基准结果和模型可用性的画面属于历史记录;做当前决策前,请以厂商最新官方信息为准。
结论
Muse Spark 在 2026 年从消费端与私有预览,发展到公开开发入口和后续 Agent 版本,已经值得严肃评估。但这不等于应当整套迁移。
对一人公司而言,合适的模型应提高每小时通过审核的产出,同时不增加复核、安全与维护负担。先测试窄路径,衡量完整任务,再让证据决定是否承担迁移成本。
相关文章
GPT-6.1 Sol 详解:价格、性能、开放范围与模型对比
GPT-6.1 Sol 以 Astra 五分之一的标准 token 价格,提供接近 Astra 的编程、电脑操作与专业工作能力。本文解释这些数字真正意味着什么。
Jev 是什么——不生成文本的决策模型
Jev 是 TypeSafe AI 发布的 System One 模型:读取状态、返回带置信度的 typed decisions,而不生成任何文本。本文拆解其 RLCD 训练方法、官方宣称的 193.6x 加速与 444.6x 成本优势,以及 Hacker News…
DeepSeek V4.1 Flash:正式版状态、规格、价格与迁移
DeepSeek V4.1 Flash 已成为正式 Flash 模型。本文核对生产模型名、1M 上下文、视觉能力、峰谷价格、退役别名、V4 Pro 临时路由,以及从限时测试版迁移时必须复测的关键项目。
https://floatboat.ai/zh/blog/meta-muse-spark-one-person-company