
DeepSeek V4 API:对单人创业者的成本真相与真实影响
DeepSeek V4 能把推理成本大幅打下来,但截至 2026 年 4 月中旬它尚未正式发布。Nova 拆解 V4 的架构创新、预测定价、自托管门槛,并直言:便宜的 token 并不会自动带来更好的工作流。
你好,我是 Nova。最近我一直在密切跟踪 DeepSeek 的定价——一半出于好奇,一半因为 API 成本是那种当你什么都自己扛时会悄悄啃食利润的东西。
DeepSeek V4 自 2026 年 3 月初以来在开发者圈子里引发了不少动静。说实话,当我真去核对这些数字时,我不得不检查了两遍。
在进入分析之前,一个重要提醒:截至 2026 年 4 月中旬,DeepSeek V4 尚未通过公开 API 正式发布。DeepSeek 官方 API 目前仍然提供 deepseek-chat 和 deepseek-reasoner,两者都映射到带 128K 上下文的 DeepSeek-V3.2——没有出现任何 V4 模型 ID,没有更新日志条目,也没有任何官方公告。以下信息反映的是目前公开渠道已知的内容:预发布架构论文、基准测试泄漏,以及 2026 年 4 月 3 日路透社关于 V4 预计"几周内"发布的报道。
话虽如此——下面是我们已知的信息、它在实践中意味着什么,以及成本故事是否真的会改变单人创业者的处境。
DeepSeek V4 是什么
DeepSeek V4 是 V3.2 的继任者——V3.2 是目前同时驱动 deepseek-chat 和 deepseek-reasoner 端点的通用模型。V4 不是与 DeepSeek R1 竞争的产品;它们服务不同的用例,就像 GPT-4o 和 o3 的关系一样。V4 负责聊天、代码补全、文档分析和 API 集成。R1 面向深度思维链推理。
相比 V3 改了什么
已发表的研究资料记录了三个架构创新:
**Engram 条件记忆(Engram conditional memory)**是最有意思的一个。传统基于 Transformer 的 LLM 把所有学到的知识压缩进神经网络权重。Engram 增加了一个新维度:通过高效查找机制加入条件记忆——把静态知识检索与动态神经推理分开。落到实践上,这就是它能支撑 1M token 上下文、又不会出现超长上下文通常伴随的检索退化的原因。一篇已发表论文显示,在 27B 测试模型上,"大海捞针"准确率从 84.2% 跳到 97%。
**DeepSeek 稀疏注意力(DeepSeek Sparse Attention,DSA)**降低了注意力复杂度,**流形约束超连接(Manifold-Constrained Hyper-Connections,mHC)**则在万亿参数规模上稳定了训练。两者结合,V4 总参数约 1 万亿,但每个 token 只激活约 37B——和 V3 的激活算力大致相当——这让模型体积虽大得多,推理成本却仍然可控。
想深入了解这些组件如何拼在一起,如果你偏技术向,DeepSeek 的 Engram 论文(arXiv:2601.07372)值得一读。
V4 Lite 与完整版
3 月 9 日,中国科技媒体报道称 DeepSeek 官网显示一次模型更新,扩展了上下文处理能力——开发者社区称之为"V4 Lite"。DeepSeek 官方尚未确认规格,但从以往发布的节奏看,这暗示分阶段推出:先上轻量变体,再上完整版。我预计 V4 Lite 用更少的算力就能跑、定价也可能更低——类似 V3.2 产品线当初相对 R1 的定位。
DeepSeek V4 API 定价与竞品对比
这才是真正有意思的地方。基于已确认的 V3.2 定价和来自 DeepSeek 官方 API 文档的预测,这是进入 V4 发布期时成本版图的样子:
下面是旗舰层级三个主要选项的对比:
模型 | 输入 /百万 token | 输出 /百万 token | 缓存输入 /百万 | 上下文窗口 | 档位 |
|---|---|---|---|---|---|
DeepSeek V4(预测,尚未上线) | 约 $0.14–$0.30 | 约 $0.28–$0.50 | 约 $0.03–$0.07 | 1M token | 最具性价比 |
DeepSeek V3.2(当前在线模型) | $0.28 | $0.42 | $0.03 | 128K token | 最具性价比 |
Grok 4.1 Fast(xAI) | $0.20 | $0.50 | 自动缓存 | 2M token | 预算友好 |
Grok 4(xAI 旗舰) | $3.00 | $15.00 | 自动缓存 | 256K token | 中端档 |
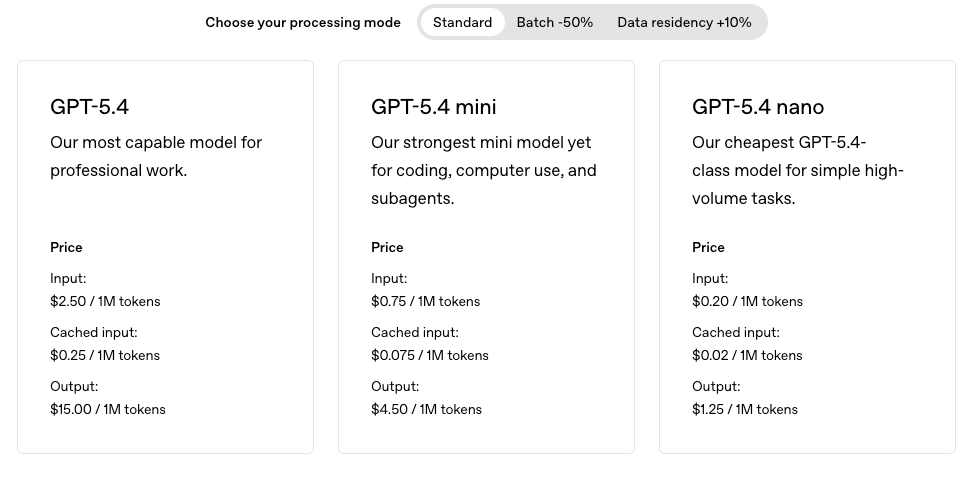
GPT-5.4(OpenAI 旗舰) | $2.50 | $15.00 | $1.25 | 272K / 1M+ | 高端档 |
GPT-5.4(超过 272K 上下文) | $5.00 | $15.00 | — | 最长 1.05M | 高端+ |
V4 的价格区间反映的是多家分析机构给出的上下限预测。官方定价只会在发布时确认。当前在线 API 定价来自 DeepSeek 官方文档。GPT-5.4 和 Grok 的价格截至 2026 年 4 月。
根据 OpenAI 官方定价页,GPT-5.4 每百万输入 token 2.50 美元、每百万输出 token 15.00 美元——而且这还没到 272K 上下文阈值,过了之后输入成本会翻倍。Grok 4.1 Fast 是每百万输入 token 0.20 美元,带 200 万 token 的上下文窗口,单 token 比 GPT-5 mini、Gemini Flash 以及 Anthropic 的所有模型都便宜。
差距是真实的。但让我说说它实际意味着什么。
DeepSeek V4 的 GitHub 与开放获取范围
对单人创业者非常重要的一件事:DeepSeek V4 将以开放权重模型发布。V4 按开源原则打造,延续了 DeepSeek 从 V3 开始的模式——据报道,V3 的训练成本是 560 万美元,而 OpenAI、Google、Anthropic 每代前沿模型要花数亿美元。
这意味着你可以自托管。实际情况呢?大约每日 5000 万 token 时,自托管的经济账开始划算。每日低于 1000 万 token,管理基础设施就显得多余——API 已经够便宜,操作上的省心值回票价。
据我认识的绝大多数单人开发者,我们离每天 5000 万 token 还远得很。API 才是正解。
模型权重会放在 Hugging Face 和 GitHub 上。API 端点在 api.deepseek.com。两个都值得收藏。
更便宜的推理会改变单人创业者的工作方式吗
好,这里我想直说。因为我觉得这方面有太多糊涂的想法。
模型成本真正是瓶颈的地方
如果你在跑高量级自动化 pipeline——批量处理数千份文档、做批量分类、规模化生成内容——那么是的,成本差异巨大。一位在生产环境跑 DeepSeek V4 的开发者报告说,一个月账单是 18 美元,而同样负载放在 GPT-4o 上大约要 380 美元。WaveSpeedAI 这笔账很难反驳。
如果你在 LLM 之上构建产品、API 成本会进入你的销售成本(COGS),同理。推理成本降 10–20 倍,直接改写你的单位经济模型。
在这些场景里,更便宜的推理是真正有意义的。
成本不是限制因素的地方
但诚实的版本是:对大多数像我一样运营一人内容、研究或产品业务的人来说,API 账单很少是真正的约束。
上个月我花了一些时间,梳理自己在 AI 辅助工作流里真正把时间丢在了哪里。大致拆解是:搭建与提示词工程(很多)、跨长会话的上下文管理(比预期的多)、推理成本(几乎为零)。模型成本在我一天里几乎是隐形的。
摩擦不在 token。摩擦在于设计不容易坏的工作流、在复杂任务中维持上下文,以及人工审阅输出所花的时间。
那些不会消失的成本
搭建时间与工作流设计
切换到新模型不是免费的。即便用 OpenAI 兼容的 API(DeepSeek 用的就是),你仍然要测试提示词、验证输出、重建工具集成。这些都是时间。
我估计,从一个正常工作的 GPT-5 环境真正迁移到 DeepSeek,视复杂度需要几个小时到几天——不是即插即用。
上下文管理的挑战
V4 的 1M token 上下文窗口听起来像做梦。对某些用例来说,它确实就是。但在这种规模上管理上下文——决定放什么、怎么结构化、避免检索退化——仍然是一个落在你头上的设计问题。
DeepSeek 宣称的 SWE-bench 分数只来自发布前的内部基准,独立评测还没有。我会劝你别基于未经证实的性能数字做基础设施决策。等第三方评测。
更便宜的模型仍然无法自动化的部分
我工作流里最耗时的任务——为语气润色、在含糊简报上做判断、决定删什么——不会因为 token 更便宜而变快或变便宜。决定速度的瓶颈是人的注意力,不是算力。
DeepSeek V4 API 对单人创业者值吗
让我给一个真正的答案,而不是"看情况"。
什么时候 DeepSeek V4 是对的
如果你在构建的东西里,API 成本会进入你的商业模式——SaaS 产品、批量处理 pipeline、规模化高量内容生成——用它。成本差异大到足以左右选择。
如果你在实验、想无成本顾虑地测试长上下文行为,也值得用。1M token 窗口加上低定价,是真实的组合。
成本节省什么时候真的重要
当你拥有能从缓存命中受益的重复提示词结构时,节省会复利。如果你的提示词共享公共前缀——系统指令、工具定义、文档模板——缓存输入 token 每百万只要 0.03 美元,打了九折。一个提示词结构良好的生产应用,有效输入成本可以做到每百万 token 低于 0.05 美元。
不管最终用哪个模型,都值得围绕这一点去设计提示词。
什么时候还是该选其他方案
如果你的工作涉及硬核的多文件编码问题,或输出质量是约束的 agentic 工作流——先等独立基准出来再下注。V4 宣称的 SWE-bench Verified 约 81% 若能兑现,将以零头的成本比肩 Claude Opus 4.6,但这些数字只来自 DeepSeek 自己的测试。
如果可靠性和生态成熟度比成本更重要——目前 GPT-5.4 或 Claude Sonnet 4.6 在生产级 agentic 用途上更经受过实战考验。你可以直接在 Anthropic 的文档里核对当前的模型能力与定价。
另外:如果你有数据隐私要求,自托管是唯一真正的选项。就现阶段而言,xAI 的 API 文档和 OpenAI 的平台在企业数据处理上都更成熟。
总之,情况就是这样。成本故事是真的,架构改进也确实有趣——但 V4 还没上线,而且更便宜的 token 不会自动带来更好的工作流。未来几周值得盯紧。
上一篇系列文章:
常见问题
现在能通过官方 API 用上 DeepSeek V4 吗?
DeepSeek V4 真的比 OpenAI 便宜吗?
V4 Lite 和完整版分别什么时候用?
成本更低,对单人创业者真的有意义吗?
该自托管 DeepSeek V4,还是直接用 API?
DeepSeek V4 现在能上生产吗?
https://floatboat.ai/zh/blog/deepseek-v4-api-solo-operator